Principais destaques
- Atribuição fica mais difícil: estudo do MIT identificou que a influência de imagens individuais diminui conforme os conjuntos de treinamento crescem.
- Nem obras inteiras deixam rastro: em alguns testes, retirar todas as imagens de um artista ou de uma pessoa não produziu mudança mensurável nas imagens geradas.
- A disputa jurídica ganha outra camada: o resultado pode dificultar a atribuição de uma criação a um dado específico, mas não elimina casos de memorização ou cópia.
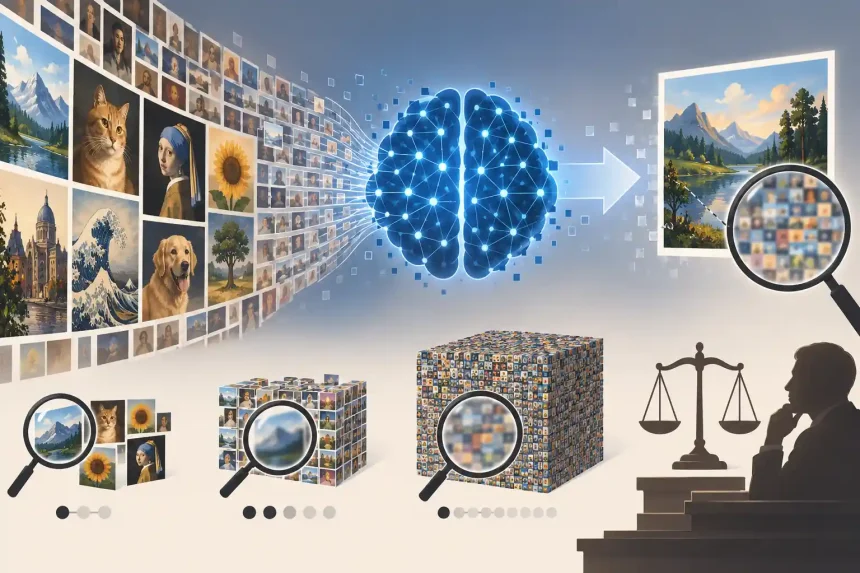
A pergunta parece simples: uma imagem gerada por IA veio de qual imagem usada no treinamento?
Um estudo do Laboratório de Ciência da Computação e Inteligência Artificial do MIT sugere que, conforme esses sistemas ficam maiores, essa resposta pode se tornar cada vez mais difícil de encontrar.
O fenômeno recebeu um nome: attribution decay, ou decaimento de atribuição.
E ele chega justamente quando a origem dos dados usados para treinar modelos de IA está no centro de uma disputa que mistura tecnologia, direito autoral e bilhões de dólares.
Quando a imagem some dentro do conjunto de dados 🔎
Os pesquisadores Zheng Dai e David Gifford criaram uma arquitetura chamada “diffusion ensemble” para investigar uma questão bastante específica: o que aconteceria se determinado modelo nunca tivesse visto uma imagem de treinamento?
A estratégia evita a necessidade de treinar modelos completamente novos milhões de vezes.
Em vez disso, os pesquisadores dividiram os dados em diferentes componentes com sobreposição entre eles. Isso permitiu desligar determinadas influências e observar se o resultado produzido pelo sistema realmente mudava.
🧪 O teste foi grande: foram avaliados 24 ensembles, usando conjuntos de dados que iam de 256 imagens a mais de 160 mil.
O padrão apareceu de forma consistente.
Quanto maior o conjunto de treinamento, menor era a influência detectável de uma imagem individual.
💡 O elo não necessariamente desaparece porque a imagem deixou de existir no treinamento. Ele desaparece porque se torna cada vez mais difícil medir quanto ela contribuiu para o resultado.
E se tirarmos todas as imagens de um artista? 🎨
Foi aí que o resultado ficou particularmente interessante.
Em alguns experimentos, os pesquisadores removeram toda a obra de determinado artista ou todas as fotografias de uma pessoa do conjunto de dados.
Ainda assim, não encontraram mudança mensurável no resultado gerado.
A lógica apresentada por Dai é direta: se retirar um dado não altera o resultado do modelo, fica difícil afirmar que aquele dado específico foi responsável por produzi-lo.
Como ele explicou no comunicado do MIT, não faria sentido atribuir o resultado àquele dado se sua remoção não provoca nenhuma alteração observável.
Isso não significa que a imagem original seja irrelevante para o treinamento. Significa algo mais específico: a influência individual pode ficar indistinguível dentro de uma massa cada vez maior de exemplos.
O tamanho do dataset muda o jogo 📈
Imagine uma receita.
Com quatro ingredientes, talvez seja relativamente simples perceber o que acontece quando você retira um deles. Com centenas de ingredientes, porém, a contribuição individual de cada componente fica muito mais difícil de separar.
É aproximadamente esse problema que o estudo coloca em evidência.
| Tamanho do conjunto | O que o estudo observou |
|---|---|
| 256 imagens | Influências individuais mais detectáveis |
| Até mais de 160 mil imagens | Influências individuais progressivamente mais difíceis de detectar |
| Remoção de grupos inteiros em alguns testes | Nenhuma mudança mensurável no resultado |
A consequência é importante porque grande parte da discussão sobre treinamento de IA parte justamente da ideia de que seria possível ligar uma saída do modelo a determinados materiais utilizados durante o treinamento.
O estudo sugere que essa ligação pode se tornar menos observável à medida que os sistemas aumentam.
E isso caiu no colo dos tribunais ⚖️
A descoberta aparece em um momento particularmente delicado para as empresas de IA.
Processos envolvendo direitos autorais e dados de treinamento vêm colocando em discussão quais materiais foram utilizados para construir esses modelos e qual relação existe entre esses materiais e aquilo que os sistemas produzem.
No ano passado, Disney, NBCUniversal e DreamWorks entraram com uma ação de propriedade intelectual contra o gerador de imagens Midjourney.
Em 2023, o The New York Times processou a OpenAI e a Microsoft.
Também está em andamento o caso Andersen v. Stability AI, no qual autores buscaram acesso aos conjuntos de dados de treinamento do Midjourney e alegaram que imagens foram coletadas para imitar estilos de artistas específicos.
⚖️ O problema jurídico é justamente o vínculo: se uma saída não pode ser atribuída de maneira confiável a uma imagem específica, demonstrar a relação entre o material de treinamento e o resultado pode ficar mais complicado.
Dai resumiu a questão ao Semafor ao dizer que talvez seja necessário repensar o significado de propriedade intelectual nesse contexto, porque o vínculo de atribuição pode desaparecer.
Mas isso não significa “IA nunca copia” 🚨
Aqui está a ressalva que impede uma interpretação muito mais ampla do estudo.
Os pesquisadores não afirmam que modelos de IA são incapazes de copiar.
Memorização e reprodução de exemplos específicos do treinamento continuam sendo possíveis.
Ou seja, há uma diferença importante entre duas perguntas:
• O modelo consegue reproduzir uma imagem específica que viu? Sim, isso pode acontecer.
• É possível demonstrar que uma determinada imagem de treinamento causou determinado resultado? O estudo sugere que essa atribuição pode se tornar progressivamente mais difícil.
São problemas relacionados, mas não são a mesma coisa.
E ainda falta testar outros tipos de IA 🤖
Há outra limitação importante.
O estudo analisou modelos de difusão, tecnologia amplamente utilizada na geração de imagens.
Isso não permite concluir automaticamente que o mesmo comportamento ocorre em outros tipos de modelos.
Uma questão em aberto é justamente saber se o mesmo fenômeno de decaimento de atribuição aparece em grandes modelos de linguagem.
🔬 A fronteira ainda está aberta: o resultado descreve um comportamento observado em determinados sistemas de geração de imagens, não uma regra universal sobre toda inteligência artificial.
Então os tribunais ficam sem resposta?
Não necessariamente.
James Grimmelmann, professor de direito na Cornell Law School e no Cornell Tech, afirmou que o artigo oferece razões para acreditar que a atribuição pode falhar em modelos sofisticados.
Nesse cenário, segundo ele, tecnólogos e tribunais precisariam recorrer a outros métodos para avaliar a existência de cópia.
Essa pode ser a consequência mais interessante do estudo.
Se o caminho tradicional de “encontre a imagem original e prove que ela causou este resultado” fica menos confiável em sistemas maiores, a discussão jurídica pode precisar olhar para outros tipos de evidência.
O estudo, portanto, não encerra a disputa sobre direitos autorais em IA. Ele torna uma das perguntas centrais ainda mais complicada.
E há uma ironia nisso tudo: quanto maior fica a máquina que transforma milhões de imagens em algo novo, mais difícil pode ser apontar para uma única imagem e dizer que ela está por trás do resultado.
O rastro não necessariamente deixa de existir. Talvez seja o nosso poder de encontrá-lo que esteja ficando para trás.