- A internet está ficando “contaminada” para o treinamento de IA
- Livreiros começaram a receber pedidos incomuns
- Projeto Panama revelou como funciona essa operação
- Por que destruir os livros em vez de simplesmente escaneá-los?
- A discussão jurídica continua longe do fim
- Livros raros preocupam bibliotecários e especialistas
- A disputa agora é por conhecimento humano
Principais destaques
- A falta de dados de qualidade na internet levou empresas de inteligência artificial a comprar milhões de livros físicos para criar novas bases de treinamento.
- Documentos judiciais revelaram que a Anthropic criou um projeto secreto para digitalizar e destruir livros em larga escala utilizando equipamentos industriais.
- A prática reacende discussões sobre direitos autorais, preservação cultural, acesso ao conhecimento e o futuro do treinamento de modelos de IA.
A inteligência artificial vive uma nova fase da chamada “corrida pelos dados”. Se nos últimos anos os laboratórios de IA extraíam praticamente tudo o que podiam da internet aberta, agora o foco mudou completamente.
Em vez de depender apenas de páginas da web, fóruns, artigos e redes sociais, grandes empresas estão voltando seus olhos para bibliotecas, sebos, distribuidoras e livrarias de livros usados.
O motivo é simples: os melhores dados para treinar uma IA já não estão mais na internet.
Nos últimos meses, documentos judiciais, reportagens e relatos de livreiros revelaram uma operação global envolvendo a compra de milhões de livros físicos.
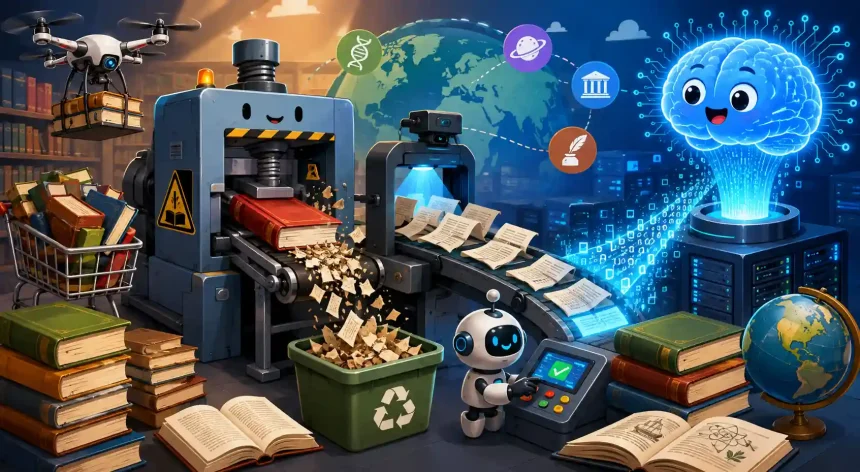
Após serem adquiridos legalmente, esses exemplares passam por um processo conhecido como digitalização destrutiva, no qual suas lombadas são removidas por máquinas hidráulicas para que cada página seja escaneada em alta velocidade. Depois disso, na maioria dos casos, o livro físico deixa de existir e segue para reciclagem.
Embora a prática exista há anos em projetos de preservação documental, ela ganhou outra dimensão quando passou a ser utilizada para alimentar modelos de linguagem como Claude e outros sistemas de IA generativa.
A internet está ficando “contaminada” para o treinamento de IA
Pode parecer contraditório imaginar que exista falta de dados em uma internet com bilhões de páginas, mas esse é justamente um dos maiores desafios enfrentados atualmente pelos laboratórios de inteligência artificial.
Desde o lançamento do ChatGPT, no final de 2022, o volume de textos produzidos por inteligência artificial cresceu de forma exponencial. Hoje existem milhões de artigos, blogs, comentários, descrições de produtos e publicações criadas parcial ou totalmente por IA.
Isso gera um fenômeno conhecido entre pesquisadores como contaminação dos dados. Quando um modelo passa a aprender utilizando conteúdo produzido por outras inteligências artificiais, existe o risco de perda gradual de qualidade, repetição de erros, simplificação excessiva da linguagem e redução da diversidade das informações.
Em estudos acadêmicos, esse problema também é relacionado ao chamado “model collapse”, situação em que sucessivas gerações de modelos passam a aprender sobre respostas produzidas por outras IAs, degradando o conhecimento ao longo do tempo.
É justamente por isso que livros publicados antes da explosão da IA generativa passaram a ser considerados um dos ativos mais valiosos da indústria.
Além de serem escritos exclusivamente por humanos, essas obras normalmente passaram por revisão editorial, correção técnica, checagem de fatos e diversas etapas de edição, oferecendo um nível de qualidade muito superior ao encontrado em boa parte do conteúdo disponível atualmente na web.
Livreiros começaram a receber pedidos incomuns
Um dos episódios que trouxe essa prática para o conhecimento público aconteceu na Holanda.
O livreiro antiquário Pieter de Vries recebeu uma planilha contendo mais de três mil ISBNs específicos de livros acadêmicos. O pedido partia de uma compradora identificada apenas como “Natalia”, ligada à empresa 2077AI, e solicitava o envio das obras para a China.
Inicialmente, o comerciante acreditou que se tratava de uma tentativa de golpe. Entretanto, descobriu posteriormente que fazia parte de uma grande operação internacional que estava entrando em contato com centenas de sebos e vendedores especializados em diversos países.
A lista incluía principalmente livros acadêmicos publicados entre 2020 e 2021 por editoras como Oxford University Press, Elsevier e Wiley, materiais considerados extremamente valiosos para o treinamento de modelos de inteligência artificial por apresentarem conhecimento técnico, linguagem revisada e baixa probabilidade de conter informações geradas por IA.
Relatos semelhantes começaram a surgir em diferentes regiões da Europa, indicando um aumento incomum nas compras em larga escala de livros usados.
Projeto Panama revelou como funciona essa operação
A dimensão da estratégia ficou ainda mais clara após a divulgação de milhares de páginas de documentos judiciais relacionados a um processo de direitos autorais envolvendo a Anthropic.
Entre os documentos apareceu uma iniciativa interna chamada Projeto Panama, descrita pela própria empresa como um esforço para “digitalizar destrutivamente todos os livros do mundo”. A documentação também indicava que o projeto deveria permanecer discreto e que seus detalhes não deveriam ser divulgados publicamente.
Segundo os registros apresentados à Justiça, a empresa investiu dezenas de milhões de dólares na compra de livros físicos durante aproximadamente um ano.
Para acelerar o processo, utilizava equipamentos industriais capazes de cortar a lombada das obras em poucos segundos. As páginas eram então alimentadas automaticamente em scanners de alta velocidade, que produziam cópias digitais de alta resolução antes de encaminhar os restos físicos para reciclagem.
A operação foi liderada por Tom Turvey, ex-executivo do Google que participou do projeto Google Books, iniciativa responsável por digitalizar milhões de obras ao longo das últimas duas décadas.
Por que destruir os livros em vez de simplesmente escaneá-los?
Essa é uma das perguntas mais feitas desde que o caso veio a público.
Embora existam scanners capazes de digitalizar livros preservando totalmente o exemplar, esses equipamentos são muito mais lentos, caros e exigem manipulação manual de cada página.
Já a digitalização destrutiva permite transformar milhares de livros em arquivos digitais diariamente.
Na prática, cortar a lombada faz com que cada folha se solte, permitindo que scanners industriais processem centenas de páginas por minuto com menor índice de erro.
A técnica já era utilizada anteriormente por universidades, bibliotecas e empresas especializadas em digitalização de grandes acervos, mas sua adoção em escala industrial para treinamento de inteligência artificial levantou novas questões éticas.
A discussão jurídica continua longe do fim
Do ponto de vista legal, o cenário é complexo.
Em uma decisão recente, um juiz federal dos Estados Unidos concluiu que a digitalização de livros comprados legalmente para treinamento de modelos de IA pode ser considerada um uso transformador, enquadrando-se na doutrina do fair use. Na avaliação do magistrado, a utilização das obras para ensinar padrões de linguagem a um sistema de inteligência artificial não equivale à reprodução comercial direta dos livros.
No entanto, a mesma disputa também revelou outro problema.
Antes de iniciar a compra massiva de livros físicos, a Anthropic havia sido acusada de utilizar obras obtidas em bibliotecas piratas digitais para treinar versões iniciais de seus modelos. A empresa posteriormente fechou um acordo bilionário relacionado a essas alegações, embora continue defendendo aspectos jurídicos de sua atuação.
Outras gigantes da tecnologia, incluindo Google, Meta, Microsoft e OpenAI, também enfrentam ações semelhantes envolvendo direitos autorais e uso de conteúdo protegido no treinamento de sistemas de inteligência artificial.
Livros raros preocupam bibliotecários e especialistas
Se a compra de grandes lotes de livros comuns já desperta atenção, o que mais preocupa pesquisadores e arquivistas é a possibilidade de obras raras entrarem nesse mesmo fluxo.
Livreiros especializados afirmam que alguns pedidos incluem títulos esgotados, livros acadêmicos difíceis de encontrar e exemplares publicados em idiomas pouco comuns. Em alguns casos, existem pouquíssimas cópias disponíveis no mercado.
Embora não existam evidências públicas de que exemplares únicos tenham sido destruídos, especialistas alertam que a pressão criada por esse novo mercado pode reduzir ainda mais a disponibilidade dessas obras para pesquisadores, universidades e colecionadores.
Outro ponto levantado por críticos é que, diferentemente de projetos como o Google Books ou iniciativas de bibliotecas digitais, o objetivo dessas digitalizações não é necessariamente disponibilizar os livros ao público, mas sim utilizá-los exclusivamente como matéria-prima para o treinamento de modelos proprietários.
Isso significa que o conhecimento presente nas obras ajuda a desenvolver sistemas de IA, mas as cópias digitais geralmente permanecem inacessíveis para pesquisadores, leitores e instituições culturais.
A disputa agora é por conhecimento humano
A inteligência artificial entrou em uma nova etapa de desenvolvimento. Se antes a corrida era por poder computacional e chips cada vez mais avançados, hoje ela também acontece em torno do acesso ao conhecimento produzido pela humanidade.
Livros, artigos científicos, enciclopédias e materiais técnicos passaram a ser vistos como um recurso estratégico capaz de determinar a qualidade dos próximos modelos de IA.
Ao mesmo tempo em que essa estratégia pode acelerar a evolução da tecnologia, ela também abre um debate profundo sobre preservação cultural, remuneração de autores, limites do uso transformador e quem deve controlar o acesso ao conhecimento digitalizado.
A grande questão que permanece é se o avanço da inteligência artificial conseguirá encontrar um equilíbrio entre inovação e preservação.
Afinal, alimentar máquinas com o melhor conteúdo produzido por humanos pode representar um enorme salto tecnológico, mas isso também exige discutir como garantir que esse patrimônio intelectual continue acessível para as próximas gerações, e não apenas para os servidores das maiores empresas de IA do mundo.