Principais destaques
- IA no desenvolvimento do Linux: Linus Torvalds atribuiu ao Claude Code, da Anthropic, a maior parte do trabalho em uma série experimental de oito patches para o kernel.
- Quase três vezes mais desempenho: os testes registraram até 33 milhões de leituras pequenas por segundo, contra aproximadamente 10 milhões na implementação original.
- Ainda sem adoção oficial: as mudanças permanecem em um branch experimental, com dúvidas técnicas e custos de desempenho que precisam ser avaliados.
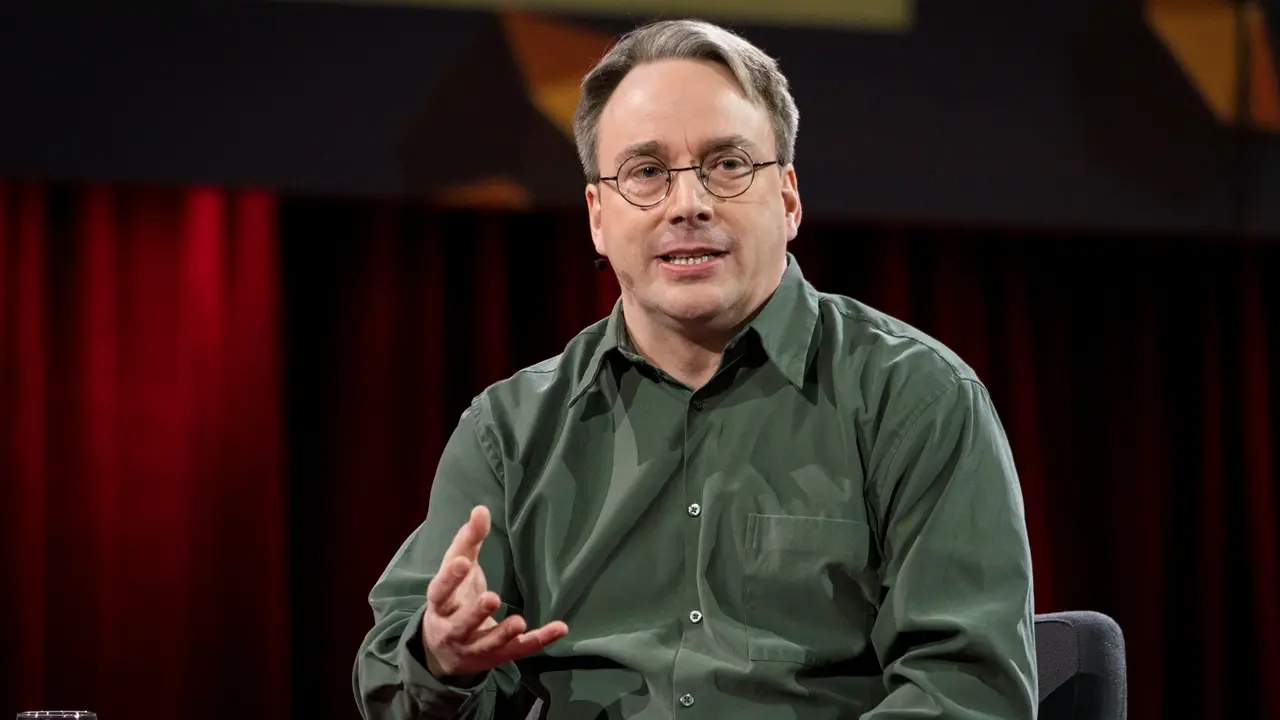
Linus Torvalds, criador do Linux, está recorrendo à inteligência artificial para enfrentar um problema de desempenho no coração do sistema operacional. Em seu repositório pessoal, ele publicou uma série de oito patches desenvolvidos principalmente com o auxílio do Claude Code, ferramenta de programação da Anthropic.
O resultado chama a atenção: em determinados testes realizados em seu próprio laptop, a implementação experimental quase triplicou a velocidade de leituras pequenas e simultâneas de um mesmo arquivo.
Não se trata, porém, de uma mudança aprovada para o kernel. O código continua em fase experimental, e ainda não existe previsão de incorporação à versão oficial.
🔧 O gargalo estava escondido na memória
O trabalho aborda um problema de contenção no page cache, mecanismo do kernel que mantém em memória cópias de dados de arquivos para acelerar o acesso posterior.
Quando várias threads leem pequenas quantidades de dados de um mesmo arquivo ao mesmo tempo, o sistema precisa atualizar repetidamente um contador de referências associado ao folio, unidade utilizada pelo kernel para administrar páginas de memória.
O problema é que essas operações podem disputar a mesma linha de cache do processador. Em vez de simplesmente ler os dados, diferentes threads acabam competindo por um recurso compartilhado.
Matthew Wilcox já havia chamado atenção para essa limitação em 2024, depois de identificá-la durante a análise da carga de trabalho de um cliente.
💡 A mudança de abordagem: em vez de tentar administrar as condições de corrida provocadas pela eliminação do contador de referências, a proposta de Torvalds busca tornar esse contador desnecessário para determinados caminhos de leitura.
Como a proposta tenta resolver o problema
A série de patches utiliza o mecanismo RCU (Read-Copy-Update), empregado pelo kernel para permitir acesso concorrente a estruturas de dados com segurança.
A ideia é permitir que leitores copiem os dados diretamente para o buffer do usuário sem precisar adquirir uma referência individual para o folio. A segurança depende de uma regra importante: páginas removidas do page cache só podem ser devolvidas ao alocador de memória depois que termina um período de carência do RCU.
Esse intervalo garante que leitores que já estavam acessando a estrutura tenham tempo para concluir suas operações.
Há também um mecanismo de controle para evitar o acúmulo excessivo de páginas aguardando liberação. Quando o total ultrapassa 1.024 páginas por CPU, o kernel força um período de carência acelerado.
A proposta, portanto, não elimina as preocupações com concorrência. Ela tenta resolvê-las de outra maneira, reduzindo o custo de sincronização no caminho mais frequente das leituras.
📊 Os números impressionam, mas há ressalvas
Os testes foram realizados em um laptop equipado com Intel Core i7-8565U, processador de quatro núcleos e oito threads. Algumas mitigações de segurança estavam desativadas, uma condição que precisa ser considerada na interpretação dos resultados.
| Cenário | Implementação original | Com os patches |
|---|---|---|
| Oito threads lendo o mesmo arquivo | 9,9 a 10,4 milhões de leituras/s | 30 a 33 milhões de leituras/s |
| Custo em ciclos de kernel por leitura | Cerca de 2.950 | Cerca de 725 |
| Leitura com uma única thread | Referência original | Aproximadamente 10% mais barata |
| Eventos de carga HITM | 30.538 | 101 |
As leituras testadas tinham apenas 16 bytes. É justamente nesse tipo de operação que o custo de sincronização pode representar uma parcela significativa do trabalho total.
A redução dos eventos de carga HITM, associados à contenção de linhas de cache entre núcleos, também sugere que a proposta ataca o gargalo identificado, em vez de apenas produzir uma melhora superficial nos resultados.
⚠️ Nem tudo ficou mais rápido: em um cenário de thread única envolvendo uma página de usuário ainda não mapeada, o custo aumentou de aproximadamente 4.150 para 6.550 ciclos.
Isso mostra que a otimização pode favorecer cargas de trabalho altamente concorrentes sem beneficiar igualmente todas as situações. Além disso, os números vêm de uma única máquina e não demonstram, por si só, como a mudança se comportaria em servidores, sistemas de arquivos e cargas de trabalho diferentes.
A IA recebeu crédito explícito no código
Michael Larabel, do Phoronix, identificou o branch experimental enquanto aguardava a tag Linux 7.3-rc7. A série de patches foi preparada sobre o Linux 7.3-rc6, acrescido de correções.
O detalhe mais interessante aparece na seção de ferramentas da carta de apresentação dos patches. Torvalds não escondeu a participação da inteligência artificial e explicou que o assistente ajudou em praticamente todas as etapas do trabalho.
O código, os programas de teste, a revisão e o primeiro rascunho da apresentação foram produzidos com um assistente de programação baseado em LLM, o Claude Code, sob a direção de Torvalds.
A distinção é importante. A ferramenta não recebeu autonomia irrestrita para alterar o kernel e publicar mudanças sem supervisão. Torvalds direcionou o trabalho, executou as medições em sua própria máquina e apresentou os resultados junto com as limitações ainda conhecidas.
Esse tipo de transparência também permite discutir uma questão cada vez mais relevante no desenvolvimento de software: como atribuir crédito a ferramentas de IA quando elas participam da implementação, dos testes e da revisão de código.
🗣 Torvalds mudou de ideia sobre a inteligência artificial?
Em 2024, Torvalds descreveu o setor de IA como sendo 90% marketing e 10% realidade. A declaração refletia seu ceticismo em relação ao entusiasmo exagerado em torno da tecnologia.
Mais recentemente, segundo reportagem do ZDNet sobre o Open Source Summit Europe, realizado em Praga, ele afirmou que gosta bastante de usar IA, embora tenha alertado para a carga adicional que essas ferramentas podem impor aos mantenedores de projetos.
O novo experimento não significa que todas as suas reservas desapareceram. Ele mostra algo mais específico: Torvalds está disposto a utilizar a tecnologia quando ela pode ajudar a investigar problemas concretos de engenharia.
Em outro branch, chamado assoc-array-fixes, ele também relatou ter utilizado ferramentas baseadas em modelos de linguagem para compreender partes pouco claras da implementação de arrays associativos do kernel após um relatório de bug.
A mudança de postura parece menos uma adesão irrestrita à IA e mais uma avaliação pragmática de onde ela pode ser útil.
🚧 O próximo passo ainda depende dos mantenedores
Apesar dos resultados promissores, a série de patches permanece experimental. Torvalds apontou questões em aberto sobre contabilização de memória e decisões de projeto que ainda precisam ser avaliadas.
Também não está confirmado se a implementação será proposta para a próxima janela de integração do Linux 7.4. Antes disso, será necessário entender melhor seus efeitos sobre diferentes cargas de trabalho e avaliar os custos introduzidos em determinados caminhos de execução.
O episódio oferece um exemplo concreto de como a IA pode participar de um projeto de infraestrutura crítica sem substituir a responsabilidade dos desenvolvedores. O ganho de desempenho é relevante, mas a segurança, a manutenção e a previsibilidade do comportamento continuam sendo requisitos fundamentais.
Se o experimento sobreviver às próximas etapas de revisão, o caso poderá servir como referência para outros desenvolvedores que investigam gargalos difíceis de encontrar. Por enquanto, o Claude Code ajudou a produzir uma proposta promissora. Transformá-la em parte do Linux oficial é outra história.