Principais destaques
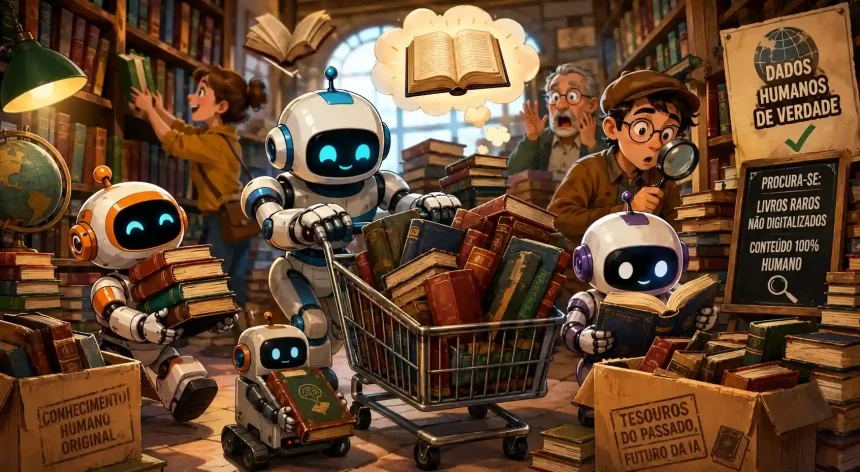
- Empresas de inteligência artificial passaram a comprar grandes quantidades de livros antigos para treinar novos modelos com textos escritos exclusivamente por humanos.
- Livreiros da Alemanha relatam uma explosão na demanda, principalmente por obras acadêmicas, técnicas e publicações que nunca foram digitalizadas.
- O movimento reacende discussões sobre direitos autorais, preservação cultural e os limites éticos do treinamento de sistemas de IA.
Durante anos, as maiores empresas de inteligência artificial alimentaram seus modelos com praticamente tudo o que estava disponível na internet. Bilhões de páginas, artigos, fóruns, livros digitalizados e sites serviram de matéria-prima para treinar sistemas como ChatGPT, Claude, Gemini e outros grandes modelos de linguagem.
Agora, porém, o setor enfrenta um problema inesperado. A internet deixou de ser uma fonte composta majoritariamente por conteúdo humano. Em poucos anos, ela foi inundada por textos produzidos por inteligência artificial, criando um ambiente em que uma IA pode acabar aprendendo com outra IA.
Para evitar esse ciclo, empresas especializadas estão voltando às estantes das bibliotecas, sebos e livrarias. Livros impressos, especialmente aqueles publicados antes da popularização da IA generativa, tornaram-se um dos ativos mais valiosos da indústria.
A estratégia representa uma mudança significativa na corrida tecnológica. Em vez de buscar mais dados online, o mercado agora procura justamente conteúdos que nunca passaram pela internet.
O crescimento do “AI slop” mudou a estratégia da indústria
Nos últimos dois anos, o termo AI slop ganhou espaço entre pesquisadores e especialistas em inteligência artificial. A expressão é usada para descrever conteúdos gerados automaticamente por IA que, embora pareçam corretos à primeira vista, frequentemente repetem informações, apresentam erros ou simplesmente reciclam textos produzidos anteriormente.
O problema vai além da qualidade do conteúdo. Modelos de linguagem aprendem identificando padrões estatísticos presentes nos dados utilizados durante o treinamento. Quando esses dados passam a conter grandes volumes de textos escritos por outras inteligências artificiais, existe o risco de os modelos começarem a reforçar os próprios erros.
Pesquisadores chamam esse fenômeno de model collapse, uma degradação gradual na qualidade das respostas quando sucessivas gerações de IA passam a aprender com conteúdos produzidos por máquinas em vez de pessoas.
É justamente por isso que livros publicados antes da explosão da IA generativa passaram a ser considerados uma fonte extremamente valiosa de conhecimento. Eles representam textos produzidos integralmente por autores humanos, preservando estilos de escrita, vocabulário, construções linguísticas e formas de argumentação que dificilmente aparecem em conteúdos gerados automaticamente.
Livreiros da Alemanha relatam uma verdadeira corrida pelos livros
Esse movimento já pode ser percebido em diversos países europeus. Segundo a emissora alemã Deutsche Welle (DW), livreiros da Alemanha afirmam que a procura por livros usados aumentou significativamente nos últimos meses.
Em fóruns especializados do setor, alguns vendedores relatam que pedidos individuais chegaram a representar um volume de vendas equivalente ao faturamento de um ano inteiro. Livros que permaneceram esquecidos nas prateleiras durante anos passaram a ser comprados em grandes quantidades.
Grande parte dessas encomendas chega por meio da empresa canadense-americana Zoom Books, responsável por localizar e adquirir obras para clientes ligados ao desenvolvimento de inteligência artificial.
Entre os títulos mais procurados estão livros científicos, obras acadêmicas, publicações sobre economia, direito, linguística, história regional e diversos materiais especializados que nunca foram disponibilizados em formato digital.
Segundo a emissora suíça SRF, esses livros despertam interesse porque contêm características linguísticas e estilos de escrita que ainda não fazem parte das bases de dados utilizadas pelas inteligências artificiais atuais.
Em outras palavras, quanto mais raro e menos digitalizado for um livro, maior tende a ser seu valor para empresas que desenvolvem modelos de linguagem.
A internet já não oferece dados suficientes
A busca por livros físicos também revela outro desafio enfrentado pela indústria.
Nos primeiros anos da inteligência artificial generativa, praticamente todo o conteúdo público disponível na internet servia como fonte de treinamento. Entretanto, especialistas afirmam que esse enorme estoque de dados está chegando ao limite.
Além da crescente presença de conteúdo criado por IA, boa parte dos grandes sites passou a restringir o acesso de robôs responsáveis por coletar informações. Empresas de tecnologia também enfrentam processos judiciais envolvendo direitos autorais e o uso de obras protegidas.
Nesse cenário, livros impressos representam uma alternativa extremamente atraente. Eles oferecem milhões de páginas produzidas por especialistas, pesquisadores, escritores e jornalistas ao longo de décadas.
É uma fonte de dados muito mais diversa do que grande parte do conteúdo publicado atualmente na web.
O Projeto Panama mostrou como funciona esse processo
A existência dessa estratégia ganhou notoriedade quando o Washington Post revelou detalhes do chamado Projeto Panama, conduzido pela Anthropic, empresa responsável pelo Claude.
Segundo a reportagem, milhões de livros físicos foram adquiridos para serem digitalizados em larga escala. Para acelerar o processo, as capas eram removidas e os exemplares passavam por scanners industriais capazes de digitalizar milhares de páginas diariamente.
Na prática, os livros eram destruídos durante a digitalização, permanecendo apenas suas versões digitais destinadas ao treinamento da inteligência artificial.
O caso chamou atenção porque demonstrou a dimensão da infraestrutura necessária para alimentar modelos de linguagem cada vez maiores.
Direitos autorais continuam no centro da discussão
Embora a compra dos livros seja legal, a utilização de seu conteúdo para treinar inteligências artificiais continua sendo alvo de intensos debates jurídicos.
Nos Estados Unidos, empresas costumam argumentar que o treinamento de IA pode ser protegido pelo princípio do fair use, mecanismo da legislação americana que, em determinadas circunstâncias, permite o uso de obras protegidas por direitos autorais sem autorização do autor.
Esse argumento já aparece em diversos processos envolvendo empresas como Anthropic, OpenAI e Meta.
Na Europa, entretanto, a situação jurídica é diferente.
Livreiros alemães demonstram preocupação com a possibilidade de o mesmo modelo de digitalização em massa ser adotado no continente. O livreiro Urban Zerfas comparou o momento atual a uma verdadeira corrida do ouro e afirmou que muitos vendedores não desejam que exemplares valiosos sejam destruídos após a compra.
Segundo ele, entidades do setor e autoridades alemãs deveriam discutir regras específicas para evitar possíveis violações da legislação de direitos autorais.
O risco de perder parte da memória cultural
Além das questões legais, especialistas também levantam preocupações relacionadas à preservação do patrimônio cultural.
O antiquário Roger Sonnewald explicou à emissora Südwestrundfunk que muitos dos livros mais procurados foram publicados a partir da década de 1970 e continuam protegidos por direitos autorais.
Segundo ele, boa parte da literatura alemã mais antiga já foi digitalizada por bibliotecas públicas. Em contrapartida, obras publicadas na segunda metade do século XX permanecem disponíveis quase exclusivamente em formato físico, tornando-se extremamente valiosas para empresas de inteligência artificial.
Caso essas obras sejam desmontadas para digitalização industrial, exemplares físicos poderão desaparecer do mercado, reduzindo a disponibilidade de edições originais para pesquisadores, colecionadores e bibliotecas.
Embora o conhecimento permaneça preservado digitalmente, parte da herança material representada pelos livros pode ser perdida.
O paradoxo da inteligência artificial
A corrida pelos livros antigos revela uma das maiores ironias da atual revolução tecnológica.
As empresas passaram anos ensinando suas inteligências artificiais com praticamente todo o conteúdo disponível na internet. Agora, o próprio sucesso da IA tornou essa estratégia menos eficiente.
Quanto mais conteúdo gerado automaticamente invade a web, maior se torna o valor daquilo que ainda foi produzido exclusivamente por pessoas.
Nesse contexto, livros esquecidos em sebos, bibliotecas e acervos particulares passaram a valer muito mais do que simples objetos de coleção. Eles representam uma das poucas fontes de conhecimento humano ainda relativamente livres da influência da inteligência artificial.
No fim das contas, o futuro da IA pode depender justamente de um recurso criado muito antes da era digital: o velho livro impresso.