- 🧩 Os dois problemas de memória que todo agente de produção enfrenta
- 🏗️ Desenhando sua arquitetura de memória
- 🔍 Construindo um pipeline de recuperação de contexto
- ✍️ Implementando memória de longo prazo que realmente persiste
- 🤝 Padrões de memória em sistemas multiagente
- ⚠️ Erros comuns e como evitá-los
- 📈 Considerações de escala para sistemas em produção
Principais destaques
- 🧠 A “memória” de um agente de IA envolve dois problemas bem diferentes: o contexto que o modelo enxerga naquela conversa (temporário) e o armazenamento persistente que sobrevive entre sessões, usuários e versões de modelo (memória de longo prazo).
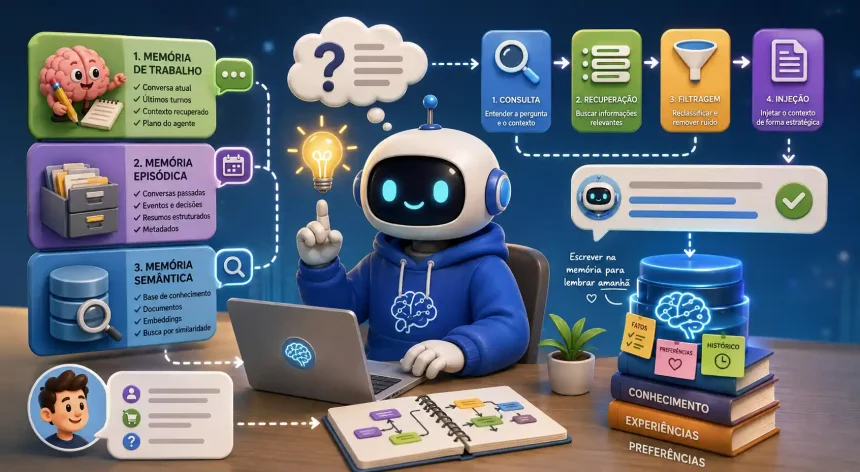
- 🏗️ Um agente bem projetado costuma se apoiar em três camadas de memória: memória de trabalho (o que está na conversa agora), memória episódica (o que já aconteceu, guardado como um registro estruturado), e memória semântica (a base de conhecimento, indexada por similaridade).
- ⚠️ Recuperar contexto em excesso piora as respostas, não melhora: poucos trechos bem selecionados costumam superar dezenas de trechos jogados no prompt, porque o modelo precisa trabalhar mais para identificar o que realmente importa.
Construir um agente de IA de demonstração é simples: você conecta um modelo, adiciona alguns prompts, e ele funciona bem o suficiente em um ambiente controlado. Mas colocar em produção um agente que atende usuários reais em escala é um problema completamente diferente.
A lacuna quase sempre se resume a contexto. Um agente de produção precisa lembrar o que aconteceu na semana passada, entender o que um usuário específico valoriza, recuperar informação relevante de bases de conhecimento grandes, e fazer tudo isso de forma confiável, ao longo de milhões de conversas, sem alucinar nem perder o fio da meada. Este guia cobre a arquitetura completa: como construir sistemas de recuperação de contexto e memória de longo prazo que funcionam de verdade, como estruturar fluxos multiagente em torno deles, e como fica a implementação na prática, com prompts prontos para cada etapa.
🧩 Os dois problemas de memória que todo agente de produção enfrenta
Antes de entrar na arquitetura, vale ser preciso sobre o problema. “Memória”, em agentes de IA, na verdade se refere a dois desafios distintos, que exigem soluções diferentes.
Memória de contexto curto vs. memória de longo prazo. A memória em contexto é tudo o que o modelo consegue enxergar na janela de prompt atual. Modelos modernos têm janelas de contexto grandes, às vezes 128 mil ou 200 mil tokens, mas isso não resolve o problema de memória em produção: janelas de contexto são caras de preencher, lentas de processar e fundamentalmente temporárias. Quando a sessão termina, tudo o que estava na janela de contexto desaparece. Já a memória de longo prazo é um armazenamento persistente que sobrevive entre sessões, usuários e até versões de modelo, informação que o agente consegue recuperar quando precisa, em vez de informação que precisa ser espremida em todo prompt.
Por que isso importa em escala. Um agente de suporte lidando com 10 mil conversas por dia não consegue carregar o histórico completo de cada usuário em cada prompt. Um agente de inteligência de vendas não consegue encaixar um CRM inteiro no seu contexto. Um assistente pessoal que esquece tudo entre sessões não é útil. Agentes de produção precisam de uma arquitetura de memória que recupere apenas o que é relevante, trazendo o contexto certo para o prompt no momento certo, e deixando o resto armazenado onde deveria estar.
🏗️ Desenhando sua arquitetura de memória
Um agente de produção bem desenhado costuma se apoiar em três camadas de memória, cada uma com um propósito diferente.
Camada 1 — Memória de trabalho (em contexto). É o “rascunho” ativo do modelo: a conversa atual, a tarefa em mãos, os fatos recuperados mais recentemente. É temporária por design. A memória de trabalho deve ser mantida o mais enxuta possível, incluindo apenas a mensagem atual do usuário, os últimos 3 a 5 turnos de conversa (não o histórico inteiro), o contexto recuperado relevante para a pergunta atual, e o plano ou estado de raciocínio atual do agente. O erro mais comum é jogar contexto demais na memória de trabalho: mais contexto nem sempre é melhor, aumenta latência, custo e o risco de o modelo perder o foco no que realmente importa.
Camada 2 — Memória episódica (armazenamento de sessão e eventos). Guarda o que aconteceu: conversas anteriores, tarefas concluídas, decisões do usuário, eventos-chave. Pense nela como um registro estruturado. Para a maioria dos agentes, isso mapeia diretamente para um banco de dados relacional: cada conversa vira um registro, e cada evento significativo (uma compra, uma atualização de preferência, um fluxo concluído) é registrado com carimbo de data/hora, ID do usuário e metadados estruturados. Um bom desenho de memória episódica significa resumir conversas longas antes de armazená-las, em vez de guardar a transcrição bruta, marcar eventos com metadados estruturados (tópico, intenção, resultado) para recuperação mais rápida, e definir políticas de retenção, já que nem tudo precisa viver para sempre.
Camada 3 — Memória semântica (conhecimento e embeddings). É a base de conhecimento do agente: fatos, documentos, preferências do usuário, informações de produto, e qualquer outra coisa que o agente possa precisar recuperar. Essa camada quase sempre envolve um banco de dados vetorial. O texto é convertido em vetores de alta dimensão, e a recuperação é feita por similaridade semântica, em vez de correspondência exata de palavra-chave. Opções populares de armazenamento vetorial para produção incluem Pinecone, Weaviate, Qdrant e pgvector (para times que já rodam PostgreSQL).
🔍 Construindo um pipeline de recuperação de contexto
A recuperação de contexto é o mecanismo que conecta sua memória armazenada ao contexto de trabalho do agente. Bem feito, faz o agente parecer inteligente e atento. Malfeito, faz o agente parecer aleatório ou esquecido.
Passo 1: divida e transforme seu conhecimento em embeddings. Documentos brutos precisam ser divididos em trechos antes de serem convertidos em vetores. O tamanho certo do trecho depende do seu caso de uso, mas de 256 a 512 tokens é um ponto de partida razoável para a maioria das bases de conhecimento. Trechos menores dão recuperação mais precisa; trechos maiores dão contexto mais coerente. Cada trecho é convertido em vetor usando um modelo de embedding de texto, e armazenado no banco vetorial com metadados (fonte, ID do documento, carimbo de data/hora, categoria).
Passo 2: desenhe sua consulta de recuperação. A consulta de recuperação costuma ser uma combinação da mensagem atual do usuário com o contexto recente da conversa. Uma abordagem mais sofisticada usa o próprio modelo para gerar uma consulta melhor.
Prompt para gerar uma consulta de recuperação otimizada:
Com base na conversa abaixo, qual informação específica seria mais útil
recuperar de uma base de conhecimento para responder à última mensagem
do usuário da melhor forma possível?

Responda apenas com a consulta de busca otimizada, sem explicações
adicionais.

Conversa:
[COLE O HISTÓRICO RECENTE DA CONVERSA]

Última mensagem do usuário:
[COLE A MENSAGEM MAIS RECENTE]
Isso adiciona latência, mas melhora de forma significativa a precisão da recuperação em conversas complexas.
Passo 3: classifique e filtre os resultados recuperados. A busca por similaridade vetorial retorna candidatos, não respostas prontas. Normalmente você recupera de 10 a 20 trechos candidatos e aplica uma etapa de reclassificação. As opções incluem reclassificação por cross-encoder (um modelo separado pontua cada candidato quanto à relevância), filtragem por metadados (recência, categoria, tags específicas do usuário), e MMR (relevância marginal máxima, que reduz redundância penalizando trechos parecidos demais com resultados já selecionados).
Passo 4: injete o contexto recuperado de forma estratégica. O contexto recuperado entra no prompt, mas a posição importa. A maioria dos modelos tem desempenho melhor quando o contexto relevante aparece perto do início do prompt (depois das instruções de sistema), não no final. Uma estrutura de prompt razoável segue esta ordem: instruções de sistema e persona do agente, contexto recuperado (claramente identificado), resumos relevantes de memória episódica, conversa atual, e a última mensagem do usuário.
Prompt de exemplo para estruturar o contexto injetado:
[INSTRUÇÕES DE SISTEMA]
Você é um assistente de suporte da empresa [NOME]. Responda apenas com
base no conhecimento fornecido abaixo. Se a informação não estiver
disponível, admita isso claramente.

[CONHECIMENTO RECUPERADO — política de devolução]
{trecho_recuperado_1}

[CONHECIMENTO RECUPERADO — histórico do usuário]
{resumo_memoria_episodica}

[CONVERSA ATUAL]
{ultimos_turnos_da_conversa}

[MENSAGEM DO USUÁRIO]
{mensagem_atual}
Rotular cada seção com clareza ajuda o modelo a entender o que está lendo e reduz alucinação.
✍️ Implementando memória de longo prazo que realmente persiste
A recuperação é só metade do quadro. A outra metade é escrever na memória de longo prazo, capturando o que o agente aprende em cada interação.
O que capturar e quando salvar. Nem toda mensagem merece ser armazenada. Um sistema de memória de produção precisa de uma lógica explícita de escrita que decida o que vale a pena salvar (preferências do usuário, fatos confirmados, tarefas concluídas, decisões importantes), quando salvar (geralmente ao final de uma sessão, ou quando um evento significativo acontece no meio da conversa), e como formatar (registros estruturados, em JSON com campos tipados, se recuperam muito melhor do que despejos de conversa em texto bruto).
Prompt para consolidação de memória ao fim de uma sessão:
Resuma a conversa abaixo e extraia fatos-chave em formato estruturado.

Retorne um JSON com os campos:
- "resumo": um resumo de até 3 frases da conversa
- "fatos_confirmados": lista de fatos que o usuário declarou explicitamente
- "preferencias": lista de preferências identificadas (comunicação,
  produto, notificação)
- "tarefas_concluidas": lista de tarefas resolvidas nesta sessão
- "pendencias": lista de qualquer coisa que ficou em aberto

Conversa completa:
[COLE A CONVERSA COMPLETA DA SESSÃO]
Segmentação de memória por usuário. Em um sistema com múltiplos usuários, a memória precisa ser segmentada por ID de usuário. Toda escrita e toda recuperação devem ficar restritas àquele usuário específico, memórias não podem vazar entre contas. Além da segmentação básica, vale organizar a memória em categorias, como preferências (estilo de comunicação, preferências de produto, configurações de notificação), histórico (compras passadas, fluxos concluídos, tickets de suporte anteriores), e contexto (projetos atuais, objetivos ativos, restrições conhecidas). Essa estrutura categorizada permite recuperação seletiva: quando um usuário pergunta sobre cobrança, você puxa o histórico de cobrança, não o perfil completo de preferências.
Lidando com conflitos e atualizações de memória. Usuários mudam. Atualizam preferências, corrigem afirmações anteriores, ou contradizem o que disseram três meses atrás. Algumas abordagens práticas: registrar carimbo de data/hora em tudo (quando dois registros conflitam, o mais recente costuma vencer), pontuação de confiança (alguns fatos são confirmados explicitamente, outros são inferidos, e essa distinção deve ser armazenada), e exclusão suave (em vez de apagar memória antiga, marcá-la como substituída, para permitir auditoria do que mudou).
🤝 Padrões de memória em sistemas multiagente
Quando você constrói sistemas com vários agentes especializados colaborando em uma tarefa, a arquitetura de memória fica mais complexa. Parte da memória deveria ser compartilhada entre todos os agentes do sistema (o perfil do usuário, conhecimento global da empresa), enquanto outra parte deveria ser específica de cada agente (as descobertas intermediárias de um agente de pesquisa que não são relevantes para o agente de resumo seguinte).
Um padrão limpo é manter um objeto de contexto compartilhado, passado entre os agentes ao longo do fluxo, junto com um repositório de memória global que qualquer agente pode consultar. Cada agente escreve de volta no contexto compartilhado se produzir informação que os agentes seguintes vão precisar. Em sistemas maiores, também faz sentido tratar a memória como um serviço dedicado, um endpoint separado que qualquer agente pode chamar para ler ou escrever, o que desacopla a lógica de memória da lógica de cada agente e facilita testar e atualizar o sistema de memória sem tocar no código dos agentes.
⚠️ Erros comuns e como evitá-los
- 📚 Recuperar contexto demais: mais trechos recuperados não significam respostas melhores; encher o prompt com 20 trechos costuma produzir resultados piores do que 3 a 5 bem selecionados, porque o modelo precisa trabalhar mais para identificar o que é relevante
- 📝 Pular a etapa de resumo: guardar transcrições brutas de conversa é tentador por ser simples, mas cria dois problemas: o custo de armazenamento cresce rápido, e a qualidade da recuperação piora, porque transcrições longas diluem o sinal
- ⏳ Não ter expiração de memória: memória antiga pode ser ativamente prejudicial; uma preferência que o usuário declarou há dois anos pode não ser mais válida; vale construir lógica de expiração, ou pelo menos um viés de recência, na classificação de recuperação
- 🚧 Não ter comportamento de contingência: a recuperação falha às vezes; o banco vetorial não retorna nada relevante, ou os resultados estão claramente fora do tópico; o agente precisa de uma saída elegante, admitindo a lacuna, fazendo uma pergunta de esclarecimento, ou seguindo com uma declaração clara do que não sabe
- 🧪 Testar componentes isoladamente: sistemas de memória interagem de formas não óbvias; uma escrita de memória em uma sessão pode afetar a recuperação em uma sessão completamente diferente, dias depois; vale testar o sistema de memória como um todo, incluindo cenários com atraso de tempo
📈 Considerações de escala para sistemas em produção
Depois que a arquitetura funciona em teste, escalar para tráfego real revela novos desafios. O desempenho do banco vetorial costuma ser bom até milhões de vetores, mas a latência de consulta pode aumentar conforme o índice cresce, então vale monitorar a latência no percentil 99, não só a média. O custo do modelo de embedding também se acumula se você gera embeddings de toda mensagem recebida e todo documento recuperado a cada requisição, então vale colocar embeddings frequentemente acessados em cache. Em sistemas distribuídos, existe uma defasagem entre o momento em que uma memória é escrita e o momento em que fica disponível para recuperação, o que precisa ser considerado no desenho da experiência do usuário. E é essencial ter visibilidade sobre o que o agente está recuperando, o que está escrevendo na memória, e quando a recuperação falha, registrando consultas, resultados retornados e o contexto final injetado em cada requisição.
Prompt para auditar a qualidade da sua recuperação:
Avalie se o contexto recuperado abaixo é suficiente e relevante para
responder à pergunta do usuário.

Pergunta do usuário:
[COLE A PERGUNTA]

Contexto recuperado:
[COLE OS TRECHOS RECUPERADOS]

Responda:
1. O contexto é suficiente para responder com precisão? (sim/não)
2. Existe alguma informação irrelevante ou fora do tópico no contexto
   recuperado?
3. Que tipo de informação, se estiver faltando, melhoraria a resposta?
Construir um agente de IA de produção com recuperação de contexto e memória de longo prazo confiáveis não é um problema de uma única tecnologia, é um problema de arquitetura que envolve armazenamento, recuperação, orquestração e observabilidade.
Separar as camadas de memória (de trabalho, episódica e semântica), recuperar de forma seletiva em vez de exaustiva, escrever na memória de forma intencional, com resumo e segmentação por usuário, tratar falhas de recuperação de forma elegante, e testar o sistema como um todo, e não só seus componentes isolados, são os pontos que separam um agente que funciona bem em demonstração de um que realmente aguenta produção em escala.