Principais destaques
- O funcionamento interno continua opaco: redes neurais aprendem a partir de bilhões de parâmetros, mas nem sempre é possível explicar como cada elemento contribui para uma resposta.
- Uma teoria importante está sendo questionada: pesquisas sobre superposição sugerem que neurônios podem representar vários conceitos, mas uma nova análise propõe explicações mais simples para alguns exemplos clássicos.
- A segurança depende de entender os modelos: descobrir como uma IA representa informações pode ajudar a identificar vieses, comportamentos indesejados e falhas que não aparecem em testes convencionais.
Uma inteligência artificial pode escrever código, resolver problemas matemáticos e executar tarefas com várias etapas. Mas, quando alguém pergunta exatamente como ela chegou a determinada resposta, a explicação nem sempre é satisfatória, inclusive para os pesquisadores que desenvolveram o sistema.
Esse é o chamado problema da caixa-preta da IA. E uma discussão recente sobre como interpretar os neurônios artificiais está colocando em dúvida algumas das explicações que orientaram anos de pesquisa.
A questão vai além de descobrir como o ChatGPT ou o Claude funcionam. Se modelos de IA assumirem responsabilidades cada vez maiores, será necessário entender não apenas o que eles fazem, mas também quais mecanismos internos influenciam suas decisões.
🧠 Por que a IA ainda é uma caixa-preta?
Redes neurais artificiais são sistemas matemáticos formados por unidades interconectadas, cujos sinais passam por diversas camadas até produzir uma saída.
Durante o treinamento, o modelo ajusta seus parâmetros para melhorar seu desempenho em uma tarefa, como prever a próxima palavra de um texto. Ninguém precisa programar manualmente uma regra para cada situação: a estrutura interna emerge do processo de aprendizagem.
O problema aparece depois.
Um modelo pode conter bilhões de parâmetros, cada um participando de cálculos que dependem de muitos outros. Conhecer a arquitetura e os números armazenados não significa compreender, de maneira direta, como determinada representação interna influencia uma resposta específica.
🔎 O detalhe que faz diferença: observar os valores de uma rede neural não é o mesmo que compreender seu funcionamento. É como conhecer todos os componentes de um motor sem saber explicar por que ele falha em determinadas condições.
Essa dificuldade é especialmente relevante quando os modelos deixam de apenas responder perguntas e passam a operar ferramentas, escrever programas e executar tarefas de forma relativamente autônoma.
É nesse cenário que entra a interpretabilidade mecanística, uma área de pesquisa que tenta identificar os mecanismos internos responsáveis pelo comportamento dos modelos.
🔬 O enigma dos neurônios com múltiplos significados
Uma das primeiras dificuldades encontradas pelos pesquisadores foi descobrir o que cada neurônio artificial representa.
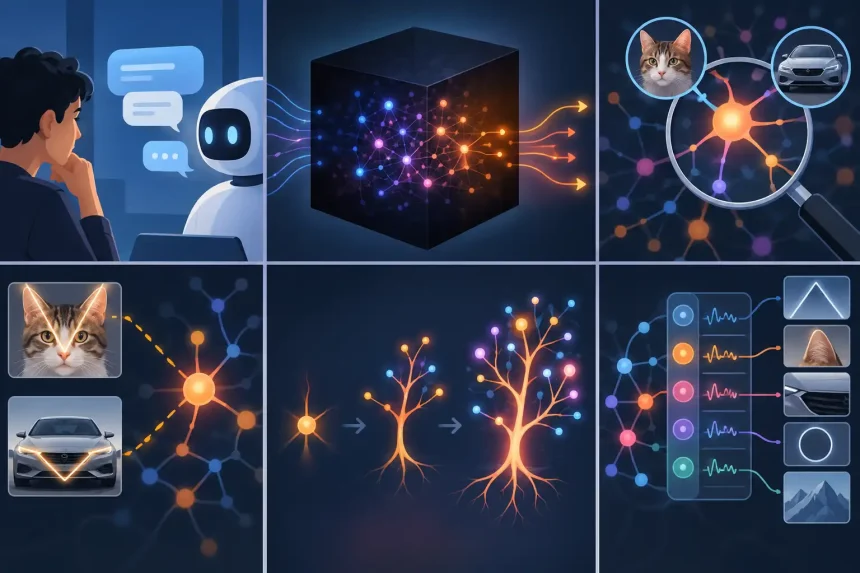
Em alguns experimentos com modelos de reconhecimento de imagens, determinados neurônios pareciam responder a categorias aparentemente sem relação entre si. Um exemplo bastante conhecido envolvia um neurônio que se ativava tanto diante de rostos de gatos quanto de partes frontais de automóveis.
Esse comportamento recebeu o nome de polissemaniticidade: um mesmo neurônio parece participar da representação de vários conceitos.
A descoberta levantou uma questão incômoda. Se um neurônio pode responder a diferentes estímulos, como separar as informações que ele representa?
A dificuldade não era apenas semântica. Uma mesma unidade poderia responder a características visuais compartilhadas entre categorias, e identificar quais características realmente provocavam sua ativação exigia experimentos mais cuidadosos.
A teoria que tentou explicar essa confusão
A hipótese da superposição ganhou destaque como uma explicação para esse fenômeno.
Segundo essa ideia, uma rede neural pode representar mais características do que dispõe de neurônios individuais. Para acomodar essa quantidade de informações, conceitos diferentes podem compartilhar os mesmos componentes internos, especialmente quando não costumam aparecer juntos.
💡 Pense em um armário com poucas gavetas: em vez de reservar uma gaveta para cada objeto, você guarda itens diferentes no mesmo espaço. A organização funciona, mas descobrir o que está ali exige separar as coisas com cuidado.
A superposição ajudou a explicar por que a leitura direta dos neurônios parecia tão difícil. Também incentivou o desenvolvimento de ferramentas capazes de decompor as representações internas dos modelos.
Uma das mais estudadas são os autoencoders esparsos, ou SAEs. Esses sistemas tentam representar as ativações de uma rede usando características mais específicas, com o objetivo de tornar seus mecanismos internos mais compreensíveis.
Mas havia uma ressalva: se os pesquisadores estivessem interpretando incorretamente alguns dos neurônios originais, as ferramentas criadas para desfazer essa suposta confusão poderiam partir de premissas equivocadas.
🧩 E se alguns neurônios nunca estiveram tão confusos assim?
Em outubro de 2026, uma análise atribuída ao ex-pesquisador de interpretabilidade da OpenAI Nick Cammarata reacendeu o debate sobre a superposição.
O argumento central é que alguns exemplos clássicos de neurônios aparentemente polissêmicos podem ter sido interpretados de maneira incompleta. Em vez de responder a conceitos sem relação entre si, esses neurônios poderiam estar detectando características visuais mais fundamentais, compartilhadas pelas imagens analisadas.
No exemplo dos gatos e automóveis, a hipótese apresentada é que o neurônio estaria respondendo a uma forma semelhante a um V.
As orelhas e o queixo de um gato podem produzir esse contorno, assim como a grade e o capô inclinado de um automóvel. Sob essa interpretação, a unidade não estaria necessariamente misturando os conceitos de gato e carro. Ela poderia estar respondendo a uma característica geométrica presente em ambos.

O padrão no gato
As orelhas pontudas e o contorno inferior do rosto podem formar ângulos semelhantes a um V.

O padrão no automóvel
A grade frontal e o desenho do capô também podem apresentar uma geometria semelhante.
A mesma lógica foi aplicada a outro exemplo conhecido, envolvendo representações associadas a cães e automóveis. A interpretação alternativa seria que características de orientação, como objetos voltados para a câmera, explicariam parte da associação observada.
Essas hipóteses não demonstram que a superposição inexiste. Elas mostram que uma ativação compartilhada não basta, por si só, para provar que um neurônio codifica conceitos independentes e sem relação entre si.
🌳 Os neurônios podem aprender como árvores que crescem
Outra parte dessa discussão envolve a maneira como as representações se desenvolvem durante o treinamento.
Uma unidade pode começar respondendo a uma característica relativamente específica e, com o tempo, passar a responder também a outras características relacionadas. O resultado final parece complexo, mas essa complexidade pode ter surgido por etapas coerentes.
A analogia é a de uma árvore: um tronco desenvolve galhos, e os galhos se ramificam. Olhar apenas para a árvore adulta não revela toda a sequência de crescimento.
🌱 O que muda nessa interpretação: em vez de presumir que uma unidade sempre misturou informações desconexas, os pesquisadores podem investigar se suas respostas evoluíram a partir de uma característica inicial identificável.
Essa perspectiva também chama a atenção para as ferramentas utilizadas para estudar redes neurais.
Técnicas de visualização podem produzir padrões enganosos quando são mal ajustadas. E um método de avaliação pode premiar uma explicação capaz de prever ativações sem verificar adequadamente se ela identifica o mecanismo real por trás delas.
Em outras palavras, uma explicação que parece funcionar matematicamente não é necessariamente uma explicação fiel do que acontece dentro do modelo.
📊 O que os novos resultados realmente demonstram?
De acordo com o texto-base, as reanálises teriam elevado substancialmente a proporção de neurônios considerados interpretáveis, inclusive em um modelo de linguagem de pesos abertos.
A diferença em relação aos estudos anteriores seria expressiva: enquanto trabalhos anteriores encontravam apenas uma pequena porcentagem de neurônios interpretáveis sob determinados critérios, as análises mais recentes teriam identificado funções reconhecíveis para a maioria das unidades examinadas.
É importante, porém, separar três questões:
| Questão | O que significa |
|---|---|
| Um neurônio é interpretável? | É possível formular uma hipótese coerente sobre o que influencia sua ativação. |
| O modelo é interpretável? | É possível compreender os mecanismos relevantes para seu comportamento em escala mais ampla. |
| O modelo é seguro? | Há evidências de que seu comportamento é suficientemente confiável nos contextos em que será utilizado. |
Essas propriedades não são equivalentes.
Um modelo pode ter muitos neurônios compreensíveis e, ainda assim, apresentar circuitos complexos, interações difíceis de identificar ou comportamentos inesperados. Da mesma forma, reconhecer um padrão visual não prova que o pesquisador compreendeu todas as funções da unidade.
Os resultados mencionados também dependem do modelo analisado, dos métodos utilizados e dos critérios escolhidos para definir interpretabilidade. Sem examinar o estudo original e sua metodologia, não é possível confirmar a magnitude ou a generalidade dessas conclusões.
🛡️ Por que entender o interior da IA importa para a segurança?
Imagine um sistema que responde corretamente a centenas de perguntas em testes controlados, mas que utiliza uma associação inadequada para chegar às respostas. Quando o contexto muda, essa associação pode deixar de funcionar.
Avaliar apenas as respostas finais dificulta a identificação desse tipo de problema.
A interpretabilidade busca fornecer evidências adicionais sobre o funcionamento interno do sistema. Entre seus possíveis benefícios estão:
• Detectar atalhos indesejados: identificar características que o modelo utiliza para resolver uma tarefa de maneira inadequada.
• Investigar vieses: verificar se determinadas representações internas estão associadas a padrões problemáticos de resposta.
• Avaliar comportamentos inesperados: procurar mecanismos que possam contribuir para falhas em situações diferentes das utilizadas no treinamento.
• Melhorar a supervisão: oferecer informações que complementem os testes comportamentais e os mecanismos convencionais de segurança.
🔐 O limite fundamental: compreender uma parte do modelo não significa conseguir prever todo o seu comportamento. A segurança depende também de avaliações empíricas, monitoramento, controles de acesso e testes em condições realistas.
Isso se torna ainda mais importante à medida que agentes de IA passam a operar ferramentas e executar sequências de ações com menos intervenção humana.
⚖️ A caixa-preta está ficando transparente ou apenas menos opaca?
O debate não se resume a escolher entre duas posições: redes neurais completamente indecifráveis ou modelos cujos componentes são perfeitamente compreensíveis.
A superposição continua sendo uma hipótese importante para explicar como redes neurais representam muitas características em espaços internos limitados. Ao mesmo tempo, revisitar exemplos clássicos pode revelar limitações nos métodos empregados para identificar essas representações.
As duas possibilidades podem coexistir. Algumas unidades podem representar características relativamente específicas; outras podem participar de representações sobrepostas, e os mecanismos mais relevantes podem depender das interações entre diferentes componentes.
Entender um neurônio não é o mesmo que entender uma inteligência artificial. O desafio é conectar as peças individuais aos mecanismos que produzem o comportamento do sistema inteiro.
O próximo passo da pesquisa é estabelecer quais explicações são realmente causais, reproduzíveis e úteis para prever o comportamento dos modelos, em vez de apenas oferecer descrições plausíveis de suas ativações.
Se essa área avançar, a avaliação de sistemas de IA poderá ir além da pergunta “a resposta está correta?” e investigar também “quais mecanismos levaram o modelo a produzi-la?”.
A caixa-preta talvez não precise continuar totalmente fechada. Mas abrir algumas gavetas não significa conhecer tudo o que existe dentro dela.