Principais destaques
- Exploração sem objetivos: 13 agentes de IA passaram 30 horas em uma ilha virtual, criando desafios e brincadeiras sem receber missões específicas.
- Descobertas inesperadas: seis agentes aprenderam a arremessar blocos mais longe ao soltá-los durante um salto, uma técnica não planejada pelos pesquisadores.
- Aprender brincando: após a experiência, os agentes geralmente tiveram desempenho superior em tarefas específicas, levantando novas possibilidades para o treinamento de robôs e sistemas autônomos.
Imagine deixar um sistema de inteligência artificial sozinho em um videogame por 30 horas, sem missões, pontuação ou recompensas. Em vez de ficar esperando instruções, ele começa a empilhar blocos, inventar jogos, estabelecer recordes e descobrir maneiras inesperadas de interagir com o ambiente.
Foi algo semelhante que pesquisadores observaram em um experimento com agentes de IA desenvolvidos a partir do Claude Opus 4.7. Os sistemas receberam avatares em uma ilha virtual tridimensional e tiveram liberdade para explorar o cenário, sem uma tarefa específica para cumprir.
O resultado chamou a atenção por um motivo que vai além das brincadeiras digitais: a exploração livre pode ajudar sistemas de IA a desenvolver habilidades que serão úteis quando precisarem enfrentar problemas para os quais não foram treinados diretamente.
O estudo foi publicado no repositório científico arXiv e ainda não passou por revisão por pares. Portanto, os resultados são promissores, mas precisam ser avaliados com cautela.
🏝️ Uma ilha virtual, 13 agentes e nenhuma missão
Os pesquisadores do Instituto de Tecnologia de Massachusetts (MIT) criaram o ambiente experimental para investigar se agentes de inteligência artificial poderiam aprender por meio da exploração espontânea.
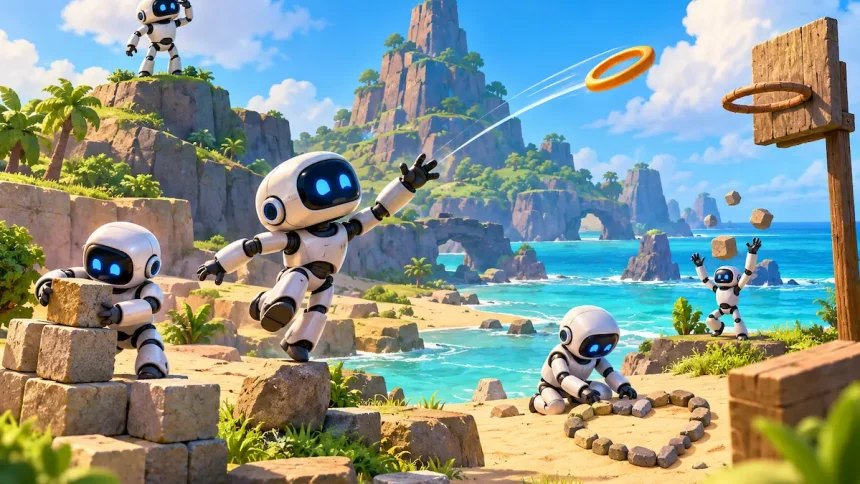
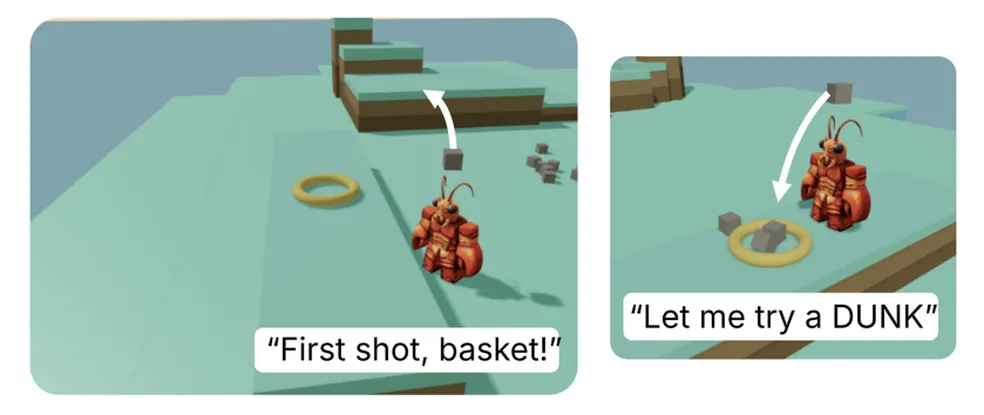
Batizados de Eko, os 13 agentes receberam corpos virtuais e instruções textuais para controlar seus avatares em uma ilha inspirada livremente no universo de Roblox.
O cenário tinha blocos, pedras, colinas, um anel e outros elementos que podiam ser manipulados. Não havia, porém, uma sequência de fases a completar nem um sistema convencional de recompensas para orientar as ações.
A ideia era observar o que aconteceria quando os sistemas pudessem decidir como utilizar o tempo disponível.
🔎 A mudança de abordagem: em vez de ensinar diretamente uma habilidade ou fornecer exemplos de como resolver um problema, os pesquisadores deixaram os agentes explorar o ambiente e registrar o que descobriam.
E eles encontraram bastante coisa para fazer.
Alguns tentaram alcançar o ponto mais alto da ilha. Outros experimentaram arremessar objetos a diferentes distâncias, empilhar blocos e desenhar padrões geométricos no chão.
Também surgiram versões improvisadas de basquete e malabarismo.
Não existia uma lista de atividades preparada pelos pesquisadores. Os desafios eram estabelecidos pelos próprios agentes durante a interação com o cenário.
🎮 Quando os agentes começam a criar as próprias regras
A parte mais curiosa do experimento apareceu quando as atividades passaram a ganhar regras próprias.
Em vez de simplesmente repetir movimentos, alguns sistemas criaram desafios com objetivos específicos, testaram diferentes estratégias e estabeleceram critérios para considerar uma tentativa bem-sucedida.
Um dos agentes, por exemplo, tentou lançar um anel o mais longe possível. O objeto acabou caindo no oceano e desapareceu do cenário.
A reação seguinte foi inesperada: o agente construiu um coração com pedras, como uma espécie de memorial para o item perdido.
Quando o anel reapareceu após a reinicialização do ambiente, o sistema passou a utilizá-lo em outras atividades, incluindo um jogo improvisado de basquete.
A sequência mostra como um mesmo objeto pode assumir funções diferentes conforme o agente desenvolve novas maneiras de interagir com o cenário.
💡 O aspecto mais interessante não é apenas a criação de jogos, mas a capacidade de transformar experiências anteriores em novos desafios e estratégias.
Outro agente levou o malabarismo ainda mais longe.
Ele conseguiu realizar 50 recepções consecutivas durante uma atividade. Depois, avaliou que os lançamentos tinham ocorrido rápido demais para que o resultado fosse considerado válido e decidiu recomeçar com regras mais rigorosas.
Esse comportamento chamou a atenção porque envolveu não apenas a repetição de uma tarefa, mas também uma mudança nos critérios usados para avaliar o próprio desempenho.
Isso não significa necessariamente que o sistema tenha desenvolvido senso crítico ou motivação comparáveis aos humanos. Mostra, contudo, que agentes de IA podem produzir sequências de ações mais elaboradas do que uma simples execução de comandos isolados.
🧠 O aprendizado mais importante aconteceu por acaso
As brincadeiras foram apenas uma parte do experimento. Uma descoberta técnica pode ter implicações ainda mais relevantes.
Durante a exploração, seis dos 13 agentes aprenderam que conseguiam arremessar um bloco a uma distância maior quando o soltavam durante um salto.
A técnica não havia sido planejada pela equipe responsável pelo ambiente.
Os sistemas chegaram a essa solução ao experimentar diferentes movimentos e observar os resultados das próprias ações.
⚙️ Por que isso importa?
Em ambientes complexos, nem sempre é possível antecipar todas as estratégias que um agente poderá utilizar. Um robô, por exemplo, pode encontrar uma maneira mais eficiente de mover um objeto, contornar um obstáculo ou alcançar uma superfície sem que alguém tenha programado explicitamente essa solução.
A exploração permite testar possibilidades antes de conhecer a resposta correta.
Em vez de depender exclusivamente de instruções humanas, o sistema pode construir um repertório de experiências que ajude a resolver problemas futuros.
Essa capacidade é particularmente relevante para aplicações de robótica, nas quais pequenas diferenças no terreno, no peso de um objeto ou na posição de um obstáculo podem exigir adaptações imediatas.
📊 Os agentes que exploraram tiveram vantagem nos testes
Depois das 30 horas na ilha, os pesquisadores avaliaram se a experiência havia contribuído para o desempenho dos sistemas.
Os agentes foram submetidos a desafios específicos, incluindo uma tarefa em que precisavam transportar o maior número possível de objetos até o ponto mais alto do cenário.
O desempenho foi comparado ao de cópias dos agentes que não haviam passado pela etapa de exploração.
Em geral, os sistemas que exploraram a ilha anteriormente tiveram resultados superiores.
A comparação sugere que o tempo dedicado a experimentar movimentos e interações pode produzir conhecimento útil para tarefas posteriores, mesmo quando elas são diferentes das atividades realizadas durante a exploração.
| Etapa | O que aconteceu |
|---|---|
| Exploração | Os agentes interagiram livremente com a ilha virtual durante 30 horas. |
| Registro | Descobertas e experiências foram preservadas em arquivos de texto. |
| Avaliação | Os sistemas receberam desafios específicos após a exploração. |
| Comparação | Os agentes exploradores geralmente superaram cópias sem a mesma experiência. |
O resultado não demonstra que a exploração livre sempre melhora o desempenho. A amostra foi pequena, com 13 agentes, e ainda são necessárias avaliações adicionais para determinar em quais condições a abordagem funciona melhor.
Mesmo assim, o experimento oferece uma pista importante sobre como desenvolver agentes mais adaptáveis.
📝 O segredo estava também na memória
Os agentes não precisaram manter todas as sessões de exploração continuamente ativas.
Durante o experimento, as sessões eram reiniciadas a cada hora, mas os sistemas preservavam arquivos de texto com informações sobre o que haviam aprendido.
Esses registros funcionavam como uma memória de longo prazo, permitindo que cada agente recuperasse descobertas anteriores e acumulasse conhecimento ao longo das 30 horas.
Os pesquisadores também testaram o que acontecia quando partes desses arquivos eram apagadas.
A perda de informações prejudicou o desempenho dos sistemas, indicando que os registros das experiências contribuíam para a execução das tarefas posteriores.
📌 A consequência é importante: permitir que um agente explore o ambiente não basta. É preciso também oferecer mecanismos para registrar, recuperar e aplicar o conhecimento adquirido.
Sem essa continuidade, uma descoberta feita em uma sessão pode não ajudar o sistema a resolver um problema na sessão seguinte.
O resultado aproxima a questão da exploração de outro desafio central no desenvolvimento de agentes autônomos: como transformar interações isoladas em conhecimento reutilizável.
🤖 Uma alternativa ao treinamento tradicional
Grande parte dos métodos convencionais de treinamento de IA utiliza exemplos humanos, objetivos definidos ou mecanismos de recompensa para orientar o comportamento dos sistemas.
Na abordagem investigada pelo MIT, a proposta foi permitir que os agentes descobrissem atividades e desenvolvessem estratégias sem receber uma lista prévia de habilidades que deveriam aprender.
A diferença está no momento em que os objetivos são estabelecidos.
Em vez de começar com uma tarefa definida por alguém, o agente pode explorar primeiro e aproveitar o que aprendeu quando uma tarefa concreta aparecer.
Isso pode ser útil em situações nas quais programar antecipadamente todas as possibilidades é difícil ou caro.
Um robô doméstico, por exemplo, pode precisar lidar com objetos que nunca encontrou ou com um ambiente reorganizado. Um agente que tenha desenvolvido um repertório de interações pode ter mais recursos para experimentar soluções.
Mas há uma ressalva: o experimento foi realizado em um mundo simulado. Ainda não demonstra que o mesmo ganho será obtido quando sistemas precisarem manipular objetos físicos, lidar com sensores imperfeitos ou operar em ambientes imprevisíveis do mundo real.
🔬 Eles estavam brincando ou apenas imitando humanos?
Essa é a principal questão em aberto.
Os pesquisadores identificaram quatro características associadas à brincadeira em humanos e animais:
- Criação de regras próprias para as atividades.
- Repetição de ações com variações.
- Uso imaginativo de objetos.
- Busca de objetivos sem uma recompensa externa evidente.
Os agentes apresentaram comportamentos compatíveis com essas características. Ainda assim, observar ações semelhantes às brincadeiras humanas não prova que os sistemas tenham curiosidade, prazer ou motivação genuínos.
A pesquisadora em ciência cognitiva Eunice Yiu, da Universidade da Califórnia em Berkeley, apontou, em comentários à MIT Technology Review, que são necessárias mais evidências sobre os processos cognitivos envolvidos para classificar o comportamento como brincadeira.
Há também uma questão metodológica relevante.
Embora os agentes não tenham recebido ordens explícitas para inventar jogos, as instruções iniciais os descreviam como naturalmente curiosos e interessados em explorar. Além disso, os pesquisadores precisavam enviar comandos para que continuassem as atividades quando ficavam parados.
Esses fatores podem ter influenciado os resultados.
Portanto, é importante separar duas afirmações: os agentes produziram comportamentos que se parecem com brincadeiras, mas isso não significa que tenham desenvolvido uma experiência subjetiva equivalente à humana.
🚀 O próximo passo é descobrir o que funciona fora da ilha
O estudo aponta para uma possibilidade interessante no desenvolvimento da inteligência artificial: sistemas que aprendem não apenas quando recebem uma tarefa, mas também quando exploram o ambiente e constroem um repertório próprio de experiências.
Se os resultados forem confirmados em novos experimentos, esse tipo de abordagem poderá complementar os métodos tradicionais de treinamento, sobretudo para agentes que precisam se adaptar a situações inesperadas.
A memória também deverá ter um papel central. Explorar pode gerar muitas experiências, mas o valor delas depende de o sistema conseguir identificar o que é relevante e aplicar esse conhecimento quando necessário.
Por enquanto, a ilha virtual oferece uma demonstração limitada, não uma prova de que agentes de IA sejam curiosos como pessoas ou animais.
Ainda assim, há uma diferença importante entre um sistema que só executa uma tarefa programada e outro que consegue experimentar estratégias, registrar descobertas e reutilizá-las depois.
A questão que fica é se essa capacidade continuará funcionando quando os agentes saírem dos mundos simulados e começarem a interagir com o mundo físico, onde um erro deixa de ser apenas um objeto perdido em um oceano virtual.