- O ataque pode estar escondido na própria tela 👀
- De uma resposta errada para um clique perigoso ⚠️
- Os modelos novos estão ficando difíceis de enganar?
- O risco também depende do tamanho do estrago 💸
- Então, por que usar computer use?
- A alternativa está no shell 🧩
- Mas customizar também significa assumir responsabilidade
- Como começar sem colocar tudo em risco 🚦
- Prompt injection não é jailbreak
- A pergunta mudou
- As chaves continuam na mão do usuário 🔐
Principais destaques
- A ameaça virou ação real: com acesso ao computador, uma injeção de prompt pode levar a cliques, comandos e alterações concretas, não apenas a uma resposta errada.
- Modelos novos resistem mais: testes práticos indicam uma melhora relevante na resistência a prompt injection, embora nenhum modelo seja considerado imune.
- O risco depende do que está em jogo: tarefas simples podem ser razoáveis, mas dinheiro, credenciais e sistemas de produção exigem permissões limitadas e supervisão humana.
A promessa dos agentes de IA mudou de escala.
Em vez de apenas responder a uma pergunta, eles podem abrir aplicativos, navegar por sites, preencher formulários, executar comandos e operar um computador quase como uma pessoa.
É justamente aí que um problema antigo ganha consequências novas.
🖥️ A diferença crucial: quando um chatbot cai em uma prompt injection, normalmente temos uma resposta ruim. Quando um agente com acesso ao computador cai na mesma armadilha, podemos ter uma ação indesejada.
E isso muda bastante a conversa sobre segurança.
O ataque pode estar escondido na própria tela 👀
O conceito de prompt injection não é novo. O princípio é relativamente simples: um agente recebe conteúdo de terceiros e interpreta aquele conteúdo como se fosse uma instrução legítima do usuário.
Pode ser texto em uma página, um arquivo, uma janela de aviso, um e-mail ou até o nome de um arquivo.
Imagine um agente encarregado de acessar um site e executar uma tarefa. Na página aparece uma mensagem maliciosa dizendo para ignorar as instruções anteriores e baixar determinado arquivo.
O agente deveria apenas ler aquilo.
Mas, se interpretar o texto como comando, o problema começa.
No computador, o ciclo costuma ser mais ou menos assim:
1️⃣ Observar: o agente captura uma tela ou recebe informações do ambiente.
2️⃣ Interpretar: o modelo analisa o que está diante dele e decide o que é relevante.
3️⃣ Agir: ele escolhe um clique, uma tecla ou um comando.
4️⃣ Executar: a ação acontece de verdade no computador.
A vulnerabilidade aparece especialmente na segunda etapa.
💡 O ponto de virada: uma instrução maliciosa deixa de ser apenas texto quando o agente tem permissão para transformá-la em ação.
De uma resposta errada para um clique perigoso ⚠️
Essa é a principal diferença entre um chatbot convencional e um sistema de computer use.
Um modelo que produz texto pode ser corrigido por um humano antes que qualquer coisa aconteça.
Um agente que controla a máquina pode não dar essa segunda chance.
Dependendo das permissões disponíveis, uma injeção bem-sucedida poderia resultar em instalação de software, envio de informações, alteração de arquivos ou preenchimento indevido de formulários.
Não significa que qualquer texto malicioso automaticamente consiga fazer isso. O resultado depende do modelo, do ambiente, das permissões e das barreiras colocadas pelo desenvolvedor.
Mas a superfície de ataque ficou muito mais concreta.
🔎 E aqui está a mudança de escala: o “output” de um agente não é necessariamente uma frase. Pode ser uma ação executada em uma máquina real.
Os modelos novos estão ficando difíceis de enganar?
Sim. Mas a resposta completa precisa de um “porém”.
Quem trabalha diretamente com ferramentas de computer use relata que modelos de fronteira mais recentes apresentam resistência significativamente maior a tentativas de prompt injection do que gerações anteriores.
Isso acompanha uma tendência mais ampla da indústria.
À medida que agentes passaram a ganhar acesso a ferramentas e computadores, os próprios modelos começaram a ser treinados para reconhecer melhor tentativas de manipular sua cadeia de instruções.
Na prática, isso mudou a percepção de alguns desenvolvedores.
Tarefas que antes pareciam arriscadas demais passaram a ser consideradas aceitáveis quando o impacto de um erro é pequeno.
🧠 Só que resistência não significa imunidade: ainda não existe evidência para tratar qualquer modelo como “à prova de injection”.
Testes adversariais continuam evoluindo, e a segurança desses sistemas ainda não possui o mesmo histórico de benchmarks consolidados encontrado em áreas como matemática ou programação.
Por isso, a afirmação “esse modelo não pode ser enganado” vai muito além do que as evidências permitem.
O risco também depende do tamanho do estrago 💸
Esse talvez seja o ponto mais útil para quem está começando a experimentar a tecnologia.
Nem toda tarefa merece o mesmo nível de paranoia.
Abrir aplicativos pela manhã, organizar abas, iniciar ferramentas de trabalho ou testar uma aplicação de desktop são atividades nas quais um erro pode custar alguns minutos e bastante irritação.
Em cenários assim, alguns usuários consideram que o ganho de produtividade já compensa o risco residual.
A lógica muda completamente quando entram em cena:
• dinheiro e pagamentos
• senhas e credenciais
• dados sensíveis
• infraestrutura de produção
• arquivos importantes
• ações irreversíveis
Aqui, um simples “vamos confiar no modelo” não é uma estratégia de segurança.
🛡️ A regra prática: quanto maior o impacto de um erro, menor deve ser a quantidade de autonomia concedida ao agente.
Então, por que usar computer use?
Porque existe um meio-termo entre “não usar” e “dar acesso total ao computador”.
Para tarefas de baixo risco, a tecnologia pode economizar tempo justamente por eliminar uma série de pequenas ações repetitivas.
Abrir cinco programas, organizar uma janela, iniciar um ambiente de desenvolvimento ou testar uma sequência de telas não parece impressionante individualmente.
Mas faça isso todos os dias.
O ganho começa a aparecer.
A questão deixa de ser “IA consegue controlar meu computador?” e passa a ser outra:
Quanto controle ela precisa ter para realizar esta tarefa?
Essa é uma pergunta de segurança muito mais útil.
A alternativa está no shell 🧩
Outra tendência entre desenvolvedores é evitar algumas estruturas pesadas de computer use.
Em vez de adotar uma plataforma completa, alguns estão criando workflows menores, chamados de skills, capazes de controlar o sistema usando ferramentas nativas.
No Windows, isso pode significar PowerShell.
No Mac, AppleScript.
No Linux, comandos tradicionais de terminal.
A ideia tem uma vantagem óbvia: transparência.
Um fluxo escrito em arquivos e scripts pode ser lido, alterado, auditado e adaptado pelo próprio desenvolvedor.
Se uma determinada situação causar problemas, é possível adicionar uma regra específica. Se uma ação for desnecessária, ela pode ser removida.
🔧 Menos mágica, mais controle: uma automação pequena e explícita pode ser mais fácil de entender do que uma ferramenta enorme que esconde boa parte do comportamento atrás de abstrações.
Isso também pode ajudar na segurança.
Um desenvolvedor consegue estabelecer limites mais claros sobre o que o agente deve fazer com informações encontradas na tela, em vez de simplesmente esperar que o modelo interprete tudo corretamente.
Mas customizar também significa assumir responsabilidade
Há uma pegadinha.
Trocar uma plataforma pronta por scripts próprios não elimina o problema de segurança. Apenas muda onde parte da responsabilidade está localizada.
Um workflow mal projetado continua podendo conceder permissões demais.
Um script que executa qualquer comando recebido do agente pode transformar uma solução “leve” em uma porta de entrada bastante poderosa.
Por isso, simplicidade não deve ser confundida com segurança automática.
🧱 A proteção precisa existir em camadas: modelo resistente, permissões limitadas, ambiente isolado quando possível e aprovação humana para operações de alto impacto.
Se uma camada falhar, outra precisa impedir que o erro vire desastre.
Como começar sem colocar tudo em risco 🚦
Para quem quer experimentar computer use hoje, a estratégia mais sensata é começar pelo que tem pouco a perder.
1️⃣ Escolha uma tarefa barata de errar: organização de janelas, abertura de aplicativos ou testes de interface.
2️⃣ Limite o ambiente: use contas e arquivos que não tenham acesso desnecessário a informações importantes.
3️⃣ Evite ações irreversíveis: pagamentos, exclusões, alterações críticas e mudanças em produção devem exigir uma camada adicional de controle.
4️⃣ Observe o comportamento: antes de aumentar a autonomia, veja como o agente reage a conteúdo inesperado na tela.
5️⃣ Aumente as permissões gradualmente: confiança deve ser conquistada pelo comportamento observado, não presumida pela capacidade do modelo.
O princípio é quase o mesmo de colocar alguém novo para operar uma máquina.
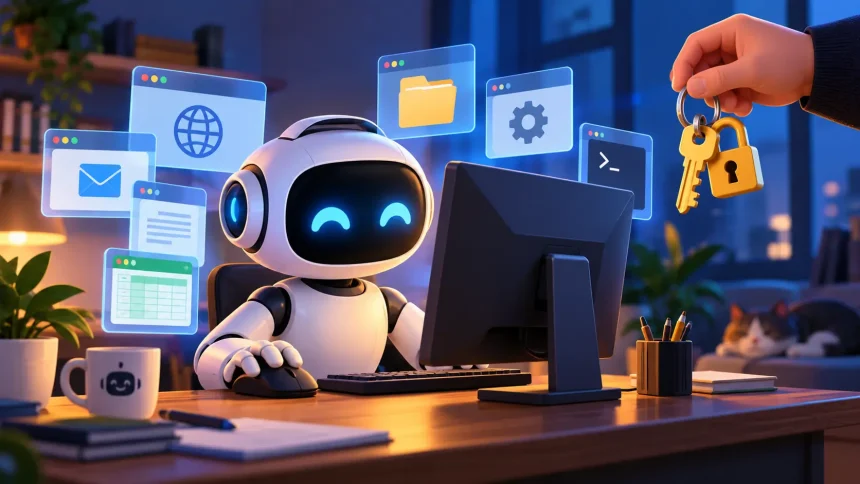
Você não entrega imediatamente todas as chaves, todos os acessos e o cartão corporativo.
Prompt injection não é jailbreak
Os dois conceitos costumam aparecer juntos, mas não são a mesma coisa.
Um jailbreak tenta fazer o próprio usuário levar o modelo a ignorar suas regras ou restrições.
Uma prompt injection vem de conteúdo externo que o agente está lendo.
É a diferença entre alguém tentar convencer diretamente o funcionário a quebrar uma regra e deixar uma instrução falsa em cima da mesa para que ele a siga acreditando que faz parte do trabalho.
No computer use, esse segundo cenário é especialmente relevante porque o agente está constantemente olhando para conteúdo que não foi produzido pelo usuário.
A pergunta mudou
Durante muito tempo, a discussão sobre segurança em agentes parecia binária:
É possível enganar o modelo?
Se a resposta fosse sim, a tecnologia parecia perigosa demais.
Hoje, com modelos mais resistentes, essa pergunta começa a perder utilidade.
A pergunta mais madura é:
💡 Se ainda existe algum risco, ele é aceitável para esta tarefa, neste ambiente e com estas permissões?
Essa mudança parece pequena, mas é importante.
Um agente que pode abrir um navegador e organizar abas não precisa ser tratado da mesma maneira que outro capaz de acessar uma conta bancária ou modificar infraestrutura de produção.
O modelo pode ser exatamente o mesmo.
O risco, não.
As chaves continuam na mão do usuário 🔐
Computer use está deixando de parecer uma demonstração futurista e começando a funcionar como uma ferramenta cotidiana.
Os modelos estão melhores. As ferramentas estão mais acessíveis. E os desenvolvedores estão encontrando maneiras mais simples de automatizar computadores.
Mas a evolução do modelo não elimina a necessidade de arquitetura de segurança.
Para tarefas simples, assumir algum risco residual pode fazer sentido.
Para tarefas críticas, a equação continua diferente.
No fim, talvez a imagem mais adequada não seja a de uma IA que “ganhou o controle do computador”, mas a de alguém recebendo acesso progressivo a uma oficina.
Primeiro, uma ferramenta.
Depois, uma bancada.
Só muito mais tarde, talvez, as chaves do prédio inteiro.
A questão é saber quem decidiu que chegou a hora de entregar a próxima chave.