Principais destaques
- Pesquisadores identificaram uma possível solução para evitar o chamado colapso de modelos de inteligência artificial.
- O estudo sugere que até mesmo um único dado humano confiável pode preservar a qualidade de sistemas treinados com conteúdo gerado por IA.
- A descoberta pode ser fundamental para o desenvolvimento seguro das próximas gerações de modelos como ChatGPT, Gemini e outras plataformas avançadas.
A inteligência artificial vive um dos períodos de crescimento mais acelerados da história da tecnologia. Novos modelos surgem constantemente, tornando-se mais rápidos, mais precisos e capazes de executar tarefas que até poucos anos atrás pareciam exclusivas dos seres humanos.
No entanto, por trás dessa evolução impressionante, existe uma preocupação crescente entre pesquisadores de todo o mundo: o que acontecerá quando os dados produzidos por pessoas começarem a se tornar insuficientes para alimentar o treinamento das futuras gerações de IA?
A questão pode parecer distante, mas diversos especialistas acreditam que ela está mais próxima do que muitos imaginam. Grande parte do conteúdo disponível na internet já está sendo criada por sistemas de inteligência artificial. Textos, imagens, vídeos, áudios e até códigos de programação são produzidos diariamente por modelos generativos que alimentam plataformas utilizadas por milhões de pessoas.
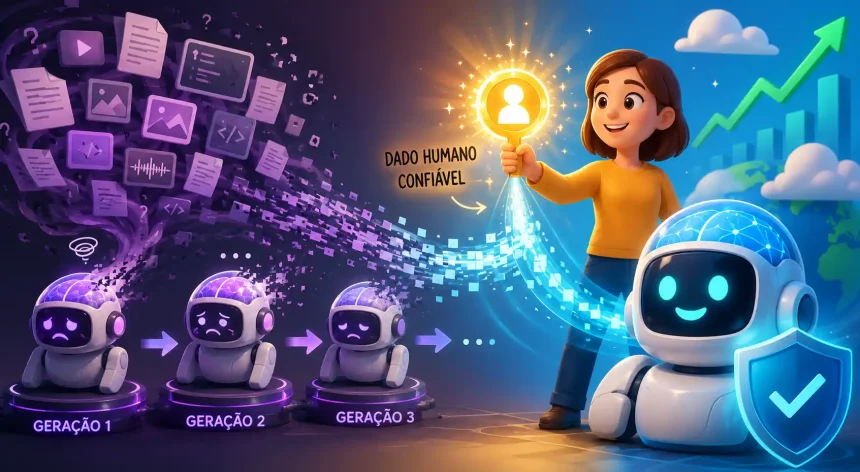
À medida que esse volume cresce, aumenta também a possibilidade de que futuras inteligências artificiais passem a aprender principalmente a partir de conteúdos criados por outras IAs. Segundo pesquisadores, esse ciclo pode gerar um problema conhecido como “model collapse”, ou colapso de modelos, um fenômeno capaz de comprometer gradualmente a qualidade e a confiabilidade dos sistemas.
Agora, um novo estudo internacional apresenta uma descoberta promissora que pode ajudar a evitar esse cenário.
O risco invisível que pode afetar a próxima geração de inteligências artificiais
O conceito de colapso de modelos vem ganhando atenção nos últimos anos porque representa um dos maiores desafios de longo prazo para a inteligência artificial. Diferentemente de falhas técnicas tradicionais, esse problema não surge de um erro de programação ou de um defeito de hardware.
Ele acontece quando sucessivas gerações de modelos passam a ser treinadas usando informações produzidas por modelos anteriores. Em outras palavras, a IA começa a aprender consigo mesma.
À primeira vista, isso pode não parecer um problema. Afinal, muitos conteúdos gerados por IA são bem escritos, organizados e aparentemente corretos. O desafio está no fato de que cada nova rodada de treinamento tende a eliminar pequenas variações, exceções e nuances presentes nos dados originais produzidos por humanos.
Com o tempo, o conhecimento disponível para o sistema torna-se cada vez mais homogêneo. As respostas continuam parecendo corretas superficialmente, mas perdem profundidade, diversidade e riqueza de detalhes.
Segundo os pesquisadores, os primeiros sintomas desse processo podem incluir respostas excessivamente genéricas, repetitivas e previsíveis. A IA continua funcionando, mas sua capacidade de lidar com situações incomuns ou perguntas complexas começa a diminuir.
Em estágios mais avançados, o problema pode se tornar muito mais sério. Os modelos passam a apresentar um número crescente de alucinações, criando fatos inexistentes, referências falsas e conclusões incorretas com aparente confiança.
Para usuários comuns, isso pode significar respostas menos úteis. Em aplicações críticas, porém, as consequências podem ser muito mais graves.
Quando erros de IA podem se tornar um problema real
O pesquisador Yasser Roudi, professor do Departamento de Matemática do King’s College London, alerta que o colapso de modelos não é apenas uma questão teórica.
Imagine, por exemplo, sistemas de inteligência artificial utilizados em hospitais para auxiliar médicos na interpretação de exames de imagem. Caso esses modelos sejam treinados com dados degradados ao longo do tempo, sua capacidade de identificar doenças pode ser comprometida.
Em um cenário extremo, isso poderia resultar em diagnósticos incorretos, atrasos na detecção de tumores ou recomendações inadequadas para pacientes.
O mesmo raciocínio vale para aplicações financeiras, sistemas de segurança, veículos autônomos e ferramentas de análise científica. Quanto mais dependemos da inteligência artificial para apoiar decisões importantes, mais relevante se torna garantir que seus conhecimentos permaneçam conectados à realidade.
Apesar dessas preocupações, os pesquisadores ressaltam que ainda não existem evidências de um colapso completo em grandes modelos utilizados comercialmente. No entanto, sinais iniciais de degradação já são observados em alguns sistemas que apresentam respostas excessivamente padronizadas ou com menor diversidade de informações.
Esse risco crescente motivou a equipe internacional a investigar possíveis formas de interromper o processo antes que ele se torne um problema concreto.
A descoberta que pode mudar o futuro do treinamento de IA
O estudo, publicado na revista científica Physical Review Letters, reuniu pesquisadores do King’s College London, da Universidade Norueguesa de Ciência e Tecnologia e do Centro Internacional Abdus Salam de Física Teórica, na Itália.
Para entender melhor o fenômeno, os cientistas utilizaram modelos matemáticos menores e mais controláveis. Em vez de trabalhar diretamente com sistemas gigantescos como os grandes modelos de linguagem atuais, eles analisaram estruturas estatísticas capazes de revelar os mecanismos fundamentais que levam ao colapso.
Os resultados chamaram atenção.
Durante os experimentos, os pesquisadores descobriram que bastava introduzir um único dado humano verificável dentro de um conjunto composto majoritariamente por informações sintéticas para impedir o processo de degradação.
Esse dado funciona como uma referência externa de realidade, uma espécie de âncora capaz de manter o aprendizado conectado a fatos genuínos.
Segundo os autores, não é necessariamente a quantidade de informação humana que faz a diferença, mas sua qualidade e sua ligação direta com uma verdade comprovável.
Em um sistema de reconhecimento de imagens, por exemplo, isso poderia significar incluir uma fotografia rotulada corretamente por especialistas humanos. Em um modelo de linguagem, poderia representar um conjunto de informações cuja precisão foi validada independentemente.
A presença desse ponto de referência parece impedir que os erros e simplificações se acumulem indefinidamente ao longo das gerações de treinamento.
O próximo desafio será testar modelos muito maiores
Embora os resultados sejam promissores, os próprios pesquisadores reconhecem que ainda existe um longo caminho pela frente.
Os experimentos foram realizados em modelos matemáticos simplificados, o que permitiu compreender os mecanismos fundamentais do fenômeno. Agora, a próxima etapa será verificar se o mesmo princípio funciona em sistemas de grande escala, semelhantes aos utilizados atualmente por empresas líderes do setor.
Caso a hipótese seja confirmada, a descoberta poderá influenciar diretamente a forma como futuras inteligências artificiais serão treinadas.
Em vez de depender exclusivamente de enormes quantidades de novos dados humanos, os desenvolvedores poderiam utilizar estratégias que preservem pontos de referência confiáveis ao longo do processo de aprendizado. Isso ajudaria a reduzir custos, manter a qualidade dos modelos e evitar uma possível degradação gradual do conhecimento.
Mais do que resolver um problema técnico, a pesquisa oferece uma visão importante sobre o futuro da inteligência artificial. Em uma era na qual máquinas produzem cada vez mais conteúdo para outras máquinas consumirem, preservar uma conexão com informações humanas verificáveis pode ser a chave para garantir que os sistemas continuem compreendendo o mundo de forma precisa.
Se essa abordagem se mostrar eficaz em larga escala, ela poderá se tornar uma das bases do treinamento das próximas gerações de IA, ajudando a evitar um cenário que muitos pesquisadores consideram um dos maiores riscos para o futuro da tecnologia.