Principais destaques
- Um alerta vindo de dentro: executivo da Microsoft descreveu a coleta de conteúdo para treinar IA como “o maior roubo de trabalho da história da humanidade”.
- Milhões de cópias em jogo: documentos citam mais de 2 milhões de arquivos do New York Times em um conjunto de dados e métodos para contornar paywalls.
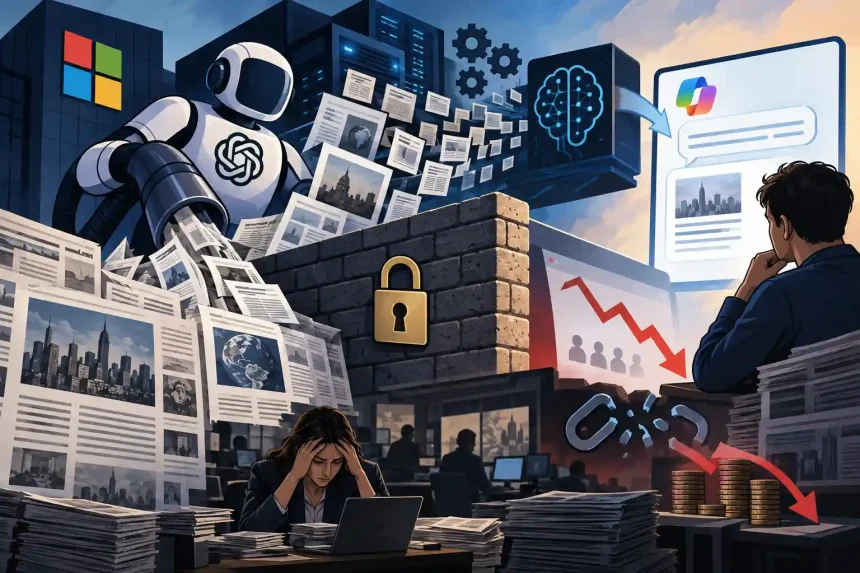
- O problema chegou ao mercado: dados internos indicam que o Copilot reduziu em até 93% os cliques do Times em comparação com a busca tradicional do Bing.
O debate sobre inteligência artificial e direitos autorais acaba de ganhar uma camada bastante incômoda para Microsoft e OpenAI.
Documentos recém-desclassificados no processo de três anos movido pelo New York Times revelam que executivos das próprias empresas discutiam internamente os riscos de usar grandes volumes de conteúdo jornalístico para treinar e alimentar sistemas de IA.
E algumas das frases registradas nos documentos são especialmente contundentes.
“O maior roubo de trabalho da história” 💥
Em um memorando interno de janeiro de 2023, Brent Hecht, diretor de Ciência Aplicada da Microsoft, classificou a coleta em massa de conteúdo jornalístico como “um roubo assombroso de proporções sem precedentes”.
Mais que isso: chamou a prática de “o maior roubo de trabalho da história da humanidade”.
Não era apenas uma preocupação sobre direitos autorais. Hecht também alertava para um problema econômico mais amplo.
Em uma apresentação de janeiro de 2024, ele afirmou que a estratégia baseada em IA da Microsoft havia criado um “ciclo vicioso”, capaz de prejudicar simultaneamente o desempenho dos próprios modelos e o funcionamento de toda a web.
🔎 O efeito colateral: se os sistemas de IA absorvem conteúdo, respondem às perguntas dos usuários e eliminam a necessidade de visitar a fonte original, os sites perdem tráfego. Com menos tráfego, há menos incentivo econômico para produzir o conteúdo que alimenta a própria internet.
💡 O paradoxo: quanto melhor a IA consegue substituir a visita à fonte original, maior pode ser o risco de enfraquecer a produção de conteúdo da qual ela própria depende.
E o Copilot aparentemente mostrou esse efeito 📉
Os documentos também apresentam dados internos da Microsoft sobre o impacto do Copilot no tráfego do New York Times.
Segundo os registros, o mecanismo de respostas baseado em IA provocou uma queda de até 93% nas taxas de cliques para o domínio do Times, quando comparado à busca tradicional do Bing.
A diferença é importante porque não estamos falando apenas de quem possui o conteúdo utilizado no treinamento.
A questão passa a ser o que acontece depois que a IA começa a responder diretamente ao usuário.
Se a pessoa recebe um resumo ou uma resposta dentro da plataforma, ela pode simplesmente não clicar no artigo original.
🗣 A própria OpenAI reconheceu o risco: Nick Turley, chefe do ChatGPT, escreveu internamente que editores enfrentavam uma “ameaça existencial” de produtos como o chatbot, que ele considerava “amplamente substitutivo”.
Greg Brockman, presidente da OpenAI, também afirmou que os modelos eram “excelentes para notícias”.
E Satya Nadella, CEO da Microsoft, testemunhou sob juramento que conversar com chatbots havia substituído o ato de obter a informação diretamente na fonte.
Não era só sobre treinamento
Esse ponto torna o processo particularmente relevante.
A discussão costuma ser apresentada como uma disputa sobre treinar modelos com material protegido por direitos autorais. Os documentos, porém, colocam em evidência uma segunda questão: o impacto comercial produzido quando a IA passa a entregar esse conhecimento diretamente ao público.
Em outras palavras, há duas etapas diferentes.
• Antes: o conteúdo é coletado e utilizado para desenvolver modelos.
• Depois: o modelo utiliza esse conhecimento para responder ao usuário sem necessariamente encaminhá-lo à publicação original.
É nessa segunda etapa que aparecem os números de tráfego.
A escala das cópias impressiona 📚
Os documentos também revelam números sobre a quantidade de material jornalístico que teria sido incorporada aos conjuntos de dados usados no desenvolvimento dos sistemas.
Segundo os registros apresentados no processo:
| Conjunto ou iniciativa | Material citado nos documentos |
|---|---|
| Dados intermediários da OpenAI | Mais de 91.692 cópias de obras de veículos como Times, Daily News e Center for Investigative Reporting |
| Conjunto derivado do Common Crawl | Mais de 2 milhões de documentos do nytimes.com |
| Projeto Mango | Pelo menos 160.903 obras únicas de veículos de imprensa |
Os números ajudam a dimensionar o tamanho da disputa.
Não se trata de alguns artigos usados como exemplos. Os documentos descrevem operações de coleta em escala massiva, envolvendo centenas de milhares ou milhões de documentos.
E então apareceram os paywalls 🔐
Talvez a parte mais delicada dos documentos esteja nos métodos usados para obter determinados conteúdos.
Segundo os registros, funcionários da OpenAI desenvolveram maneiras de contornar paywalls sem serem detectados.
Em uma conversa relatada nos documentos, o pesquisador Nick Ryder contou a Greg Brockman sobre um “truque para contornar o paywall do nytimes”.
A resposta atribuída a Brockman foi curta:
“ah, que ótimo”.
Os documentos também descrevem outra prática: a remoção de avisos de direitos autorais dos dados utilizados no treinamento.
A justificativa registrada era que os pesquisadores “não gostariam que o modelo exibisse” esses avisos aos usuários.
É justamente esse tipo de detalhe que transforma a discussão jurídica abstrata em uma disputa sobre práticas concretas de coleta e preparação de dados.
O que isso significa para o processo? ⚖️
As revelações podem ser relevantes para a defesa baseada em uso justo apresentada pela OpenAI.
Um dos pontos centrais dessa discussão é justamente o efeito que determinado uso pode produzir sobre o mercado da obra original.
Se um sistema não apenas utiliza material protegido para treinamento, mas também produz respostas capazes de substituir a consulta à publicação original, a questão sobre impacto econômico ganha outra dimensão.
E há uma declaração de Nadella que chama atenção nesse contexto.
O executivo afirmou que “qualquer conteúdo por assinatura deve ser licenciado por quem quiser utilizá-lo… para fundamentação ou treinamento”.
A frase aparece nos documentos em um momento em que a própria Microsoft enfrenta questionamentos sobre como seus produtos de IA utilizam conteúdo jornalístico.
A disputa agora é maior que um processo
O caso coloca três interesses em rota de colisão.
De um lado, estão empresas de IA que precisam de grandes volumes de informação para desenvolver modelos cada vez mais capazes.
Do outro, veículos que dependem de audiência, assinaturas e publicidade para financiar a produção desse conteúdo.
No meio está uma pergunta ainda em aberto: quando uma IA consegue consumir, resumir e entregar o conhecimento de uma publicação sem exigir uma visita à publicação, quem fica com o valor econômico daquele trabalho?
Essa pergunta não é pequena.
Ela envolve treinamento de modelos, licenciamento, mecanismos de busca, paywalls e a própria sustentabilidade financeira da imprensa digital.
💰 O dinheiro está no detalhe: uma queda de tráfego pode parecer apenas uma métrica de analytics. Para uma publicação, porém, ela pode representar menos leitores, menos assinaturas e menos receita.
E Washington também entrou nessa história 🇺🇸
A disputa jurídica acontece enquanto o debate político sobre IA e direitos autorais também avança nos Estados Unidos.
Segundo o material fornecido, no início de setembro o governo Trump apresentou um parecer defendendo o uso não licenciado de material protegido por direitos autorais pela OpenAI.
Microsoft e OpenAI não responderam aos pedidos de comentário mencionados no caso.
Isso deixa o processo em uma posição particularmente importante: as empresas precisam defender juridicamente determinadas práticas enquanto documentos internos agora públicos mostram que alguns de seus próprios executivos reconheciam riscos significativos para o ecossistema de conteúdo.
A internet nasceu baseada em uma troca relativamente simples: alguém publica, outra pessoa encontra, lê e visita a fonte.
A IA está mudando essa lógica para algo bem diferente: alguém publica, o modelo absorve, a máquina responde e o usuário pode nem precisar abrir a página.
O processo do New York Times agora oferece um raro vislumbre de como os próprios envolvidos discutiam essa transformação por dentro. A próxima disputa, portanto, talvez não seja apenas sobre quem pode copiar o quê, mas sobre quem continuará recebendo valor quando a resposta já chega antes do clique.