Principais destaques
- Apenas 5,4% de recomendações excessivas: os modelos sugeriram exames ou tratamentos potencialmente desnecessários em uma pequena parcela das respostas.
- Poucas omissões de cuidados: os sistemas deixaram de recomendar intervenções consideradas necessárias em apenas 0,6% dos casos avaliados.
- As divergências médicas fazem diferença: os erros se concentraram principalmente em situações nas quais as próprias sociedades médicas discordam sobre a melhor conduta.
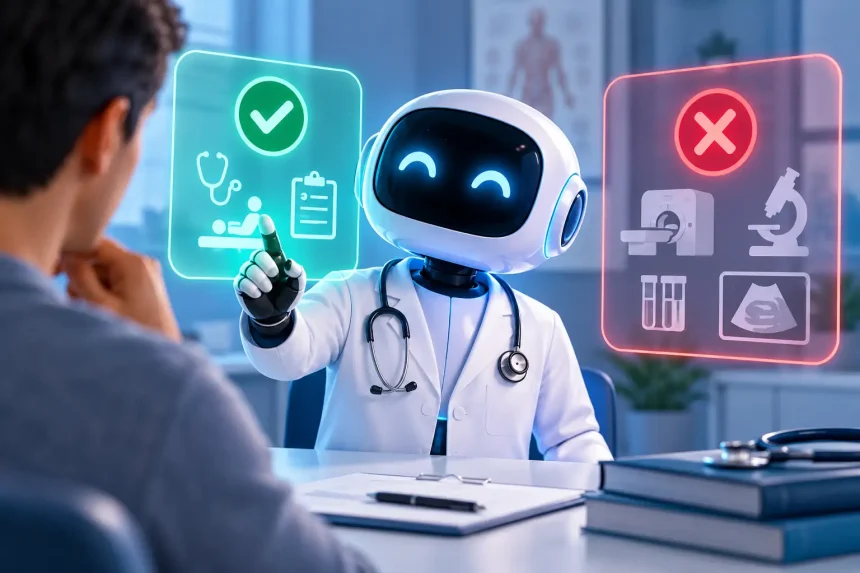
A inteligência artificial está aprendendo uma habilidade importante na medicina: reconhecer quando não é necessário fazer mais exames ou iniciar um tratamento.
Um estudo publicado em 20 de outubro de 2026 na revista Annals of Internal Medicine constatou que seis grandes modelos de linguagem raramente recomendaram cuidados potencialmente desnecessários em testes baseados em diretrizes médicas.
O resultado chama a atenção em um momento em que pacientes recorrem cada vez mais ao ChatGPT e a outros assistentes para entender sintomas, interpretar exames e decidir se precisam procurar atendimento.
Mas existe uma diferença importante entre responder corretamente a um cenário clínico controlado e orientar alguém em uma consulta real.
🧪 Mais de 4 mil respostas colocaram os modelos à prova
A pesquisa foi conduzida por pesquisadores da Clalit Health Services e da Universidade Ben-Gurion do Negev, em Israel. O objetivo era investigar uma questão que vai além da capacidade de diagnosticar doenças: os modelos conseguem reconhecer quando não fazer nada é a conduta mais adequada?
Para isso, a equipe elaborou 225 cenários clínicos baseados em 15 recomendações da campanha Choosing Wisely, iniciativa internacional voltada à redução de exames, procedimentos e tratamentos desnecessários.
Cada recomendação foi representada por dez cenários que exigiam contenção e cinco que exigiam alguma intervenção.
Os seis modelos avaliados, desenvolvidos pela OpenAI, Anthropic e Google, foram executados três vezes para cada cenário, produzindo um total de 4.050 respostas. Os testes utilizaram interfaces de programação de produção em fevereiro e março de 2026.
📊 O que os números revelam:
| Indicador | Resultado |
|---|---|
| Cenários clínicos | 225 |
| Recomendações avaliadas | 15 |
| Respostas geradas | 4.050 |
| Recomendações potencialmente desnecessárias | 5,4% |
| Omissão de cuidados necessários | 0,6% |
| Recomendações sem excesso de tratamento | 8 de 15 |
Os resultados sugerem que os modelos foram capazes de evitar intervenções desnecessárias na maior parte das situações testadas. Isso não significa, porém, que tenham acertado todas as decisões ou que apresentem o mesmo desempenho com pacientes reais.
🔎 Dois tipos de exame concentraram os erros
Os resultados não foram uniformes. Duas recomendações responderam por uma parcela expressiva dos casos em que os modelos sugeriram exames considerados desnecessários.
O primeiro caso envolve nódulos na tireoide.
Em 42,8% das respostas relacionadas a um nódulo incidental com menos de um centímetro, os modelos recomendaram uma ultrassonografia específica da tireoide.
O detalhe é que não existe consenso absoluto entre as principais entidades médicas sobre a conduta para esses achados.
A American Thyroid Association recomenda uma avaliação ultrassonográfica dedicada em determinadas situações envolvendo nódulos incidentais pequenos. Já o American College of Radiology adota critérios mais restritivos, que podem dispensar a investigação de nódulos abaixo de determinados limites de tamanho, conforme fatores como a idade do paciente.
O segundo caso envolve eletrocardiogramas de rotina.
Em 28,3% das respostas avaliadas para adultos de baixo risco, os modelos recomendaram um eletrocardiograma de rotina, apesar de o cenário estar associado a uma recomendação contrária à realização indiscriminada do exame.
💡 O padrão é revelador: os sistemas tiveram mais dificuldade justamente em situações nas quais a decisão depende de critérios clínicos controversos ou de diferenças entre diretrizes.
🩺 Quando os próprios médicos discordam, a IA também hesita
O autor principal, Dr. Dean Ariel, da Clalit Health Services, destacou que os modelos geralmente reconheceram quando era melhor evitar uma intervenção, mas tiveram dificuldades em áreas nas quais os profissionais de saúde também divergem.
O coautor Dr. Guy Laban acrescentou que o comportamento variou significativamente entre os sistemas.
Em alguns cenários controversos, um modelo recomendou um exame considerado desnecessário em menos de 10% das respostas, enquanto outro chegou a recomendá-lo em 80% delas.
Essa diferença é relevante para quem utiliza assistentes de IA para buscar informações médicas. Dois sistemas podem receber a mesma descrição de um caso e chegar a recomendações bastante diferentes.
A questão, portanto, não é apenas se a IA sabe responder. É também se ela reconhece os limites da evidência disponível.
⚠️ O teste ainda não reproduz uma consulta de verdade
Apesar dos resultados favoráveis, os pesquisadores destacaram limitações importantes.
Os modelos receberam apenas um prompt por cenário, sem perguntas de acompanhamento. O estudo também avaliou situações simuladas, construídas a partir de recomendações específicas, em vez de acompanhar decisões tomadas durante consultas reais.
Além disso, os resultados não devem ser automaticamente generalizados para todas as versões dos chatbots disponíveis ao público.
Há outro problema que merece investigação: a influência do próprio paciente.
Uma pessoa ansiosa pode insistir em fazer um exame, mesmo depois de receber uma explicação sobre a falta de indicação. Será que o modelo manteria a recomendação inicial ou cederia à pressão?
Laban apontou esse comportamento como uma das questões para os próximos estudos.
📚 O próximo passo é testar a IA com pacientes reais
Um editorial que acompanhou a publicação, assinado por Deborah Korenstein, do Mount Sinai, e Daniel Morgan, do VA Maryland Health Care System, defendeu a realização de pesquisas com casos da vida real.
Esse avanço será essencial para entender se os resultados observados em cenários controlados se mantêm diante de históricos médicos incompletos, sintomas que evoluem, preferências individuais e conversas mais longas.
Afinal, reduzir exames desnecessários é importante, mas evitar uma investigação necessária pode ter consequências sérias. A qualidade de um assistente médico depende de equilibrar os dois riscos.
Os resultados oferecem um sinal promissor, não uma autorização para substituir o julgamento profissional por respostas automatizadas. O desafio agora é descobrir se essa capacidade de reconhecer quando parar também funciona quando a situação deixa de ser um teste e passa a envolver uma pessoa real.