Principais destaques
- O mecanismo de Attention revolucionou a Inteligência Artificial ao permitir que modelos identifiquem quais palavras são mais importantes em cada contexto.
- Essa tecnologia tornou possível compreender frases longas, resolver ambiguidades e produzir respostas muito mais precisas.
- ChatGPT, Gemini, Claude, DeepSeek e praticamente todos os modelos modernos de IA utilizam alguma forma de Attention como parte de sua arquitetura.
Durante muito tempo, ensinar computadores a entender uma frase parecia uma tarefa quase impossível. As máquinas conseguiam reconhecer palavras individuais, mas tinham enorme dificuldade para compreender como elas se relacionavam dentro de um texto.
Para nós, humanos, isso acontece de forma quase instantânea. Ao ler uma frase, nosso cérebro identifica automaticamente quais palavras são mais importantes, estabelece conexões entre elas e ignora aquilo que não é essencial naquele momento.
A Inteligência Artificial moderna aprendeu a fazer algo muito parecido graças a uma tecnologia chamada Attention.
Ela representa uma das maiores revoluções da história do aprendizado de máquina e é considerada o coração da arquitetura Transformer, apresentada em 2017 no artigo científico Attention Is All You Need. Desde então, praticamente todos os grandes modelos de linguagem passaram a utilizar esse mecanismo para compreender textos, gerar respostas, traduzir idiomas e interpretar documentos complexos.
Embora o nome possa parecer técnico, a ideia por trás da Attention é surpreendentemente simples: permitir que a IA saiba exatamente em quais informações deve prestar atenção antes de tomar qualquer decisão.
O problema que existia antes da Attention
Antes dos Transformers, a maioria dos modelos de linguagem utilizava arquiteturas recorrentes, como RNNs (Redes Neurais Recorrentes) e, posteriormente, LSTMs (Long Short-Term Memory).
Esses modelos processavam um texto palavra por palavra.
Imagine a frase:
“O banco estava cheio de gente.”
A máquina lia primeiro “O”, depois “banco”, depois “estava”, e assim sucessivamente.
Embora esse método funcionasse razoavelmente bem para frases pequenas, ele apresentava uma limitação importante.
Quanto maior o texto, mais difícil era lembrar das primeiras informações.
Era como tentar entender o final de um livro lembrando apenas vagamente do primeiro capítulo.
Esse problema ficou conhecido como dependência de longo alcance. Em textos extensos, muitas informações importantes acabavam sendo esquecidas durante o processamento.
Além disso, todo o processamento era sequencial, tornando o treinamento muito mais lento.
Era necessário encontrar uma forma diferente de compreender contexto.
O nascimento da Attention
Em 2017, pesquisadores do Google publicaram um artigo que mudou completamente o rumo da Inteligência Artificial.
O trabalho recebeu um nome que hoje se tornou histórico:
Attention Is All You Need.
A proposta era radical.
Em vez de analisar palavras uma após outra, o modelo poderia observar toda a frase simultaneamente e decidir quais palavras mereciam mais atenção.
Isso eliminava grande parte das limitações das arquiteturas anteriores e permitia treinamento paralelo, acelerando significativamente o aprendizado.
Poucos anos depois, praticamente toda a indústria adotou essa abordagem.
Modelos como GPT, BERT, T5, Llama, Gemini, Claude, Mistral e DeepSeek utilizam variações desse mesmo conceito.
O que significa “prestar atenção”?
A palavra Attention pode ser entendida literalmente.
Imagine que você está lendo a frase:
“O banco estava cheio de gente.”
Quando chega à palavra “banco”, imediatamente surge uma dúvida.
Estamos falando de um banco financeiro?
Ou de um banco de praça?
Você só consegue responder depois de continuar lendo.
Ao encontrar a expressão “cheio de gente”, seu cérebro entende que provavelmente se trata de uma agência bancária.
Ou seja, para interpretar corretamente a palavra “banco”, você precisou observar outras palavras da mesma frase.
É exatamente isso que a IA faz.
Cada palavra olha para todas as outras e calcula quais delas ajudam mais a compreender seu significado naquele contexto específico.
Essa é a essência da Attention.
Como funciona a matriz de atenção?
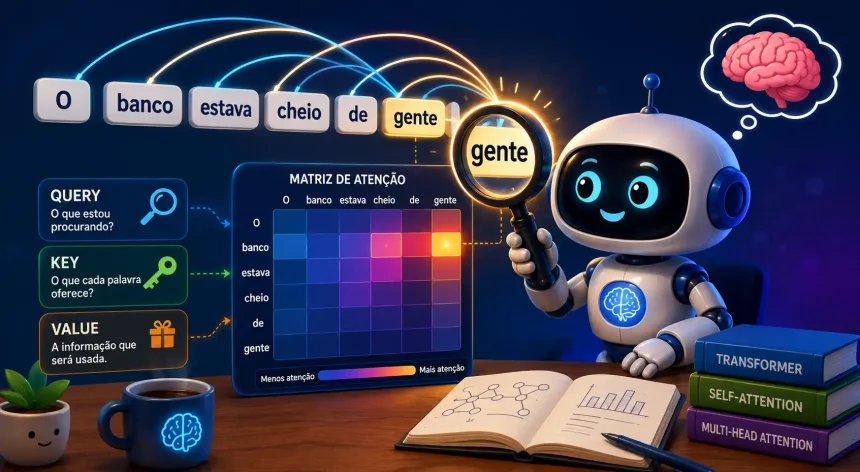
A imagem acima ilustra exatamente esse processo.
Cada palavra da frase pode “olhar” para todas as demais.
No exemplo:
O | banco | estava | cheio | de | gente
a palavra “banco” analisa o restante da frase para descobrir quais termos carregam informações importantes.
A IA cria então uma matriz de atenção.
Essa matriz funciona como uma tabela de pesos.
Quanto maior o peso, maior a influência daquela palavra sobre a interpretação da palavra analisada.
Na ilustração, percebe-se que “banco” atribui mais importância às palavras “cheio” e principalmente “gente”.
Isso acontece porque esses termos ajudam a definir o contexto.
Se a frase fosse:
“O banco aprovou o empréstimo.”
a atenção provavelmente se concentraria em palavras como “aprovou” e “empréstimo”, levando o modelo a interpretar “banco” como uma instituição financeira.
A mesma palavra recebe interpretações diferentes dependendo das conexões estabelecidas pela matriz de atenção.
Query, Key e Value: os três elementos da Attention
Por trás desse mecanismo existem três conceitos fundamentais: Query, Key e Value.
Esses nomes aparecem frequentemente em artigos sobre IA e podem parecer complicados, mas a lógica é bastante intuitiva.
Imagine uma biblioteca.
Cada livro possui uma etiqueta de identificação.
Quando você procura um livro sobre astronomia, sua busca funciona como uma Query.
As etiquetas dos livros funcionam como Keys, permitindo identificar quais deles correspondem ao assunto desejado.
Já o conteúdo encontrado representa o Value, ou seja, a informação que realmente será utilizada.
Na IA acontece algo semelhante.
Cada palavra gera três representações matemáticas diferentes:
- Query (Consulta): indica o que aquela palavra está procurando para compreender seu contexto.
- Key (Chave): informa quais características cada palavra oferece às demais.
- Value (Valor): contém as informações que serão compartilhadas após o cálculo da atenção.
O modelo compara Queries com Keys de todas as palavras da frase. Quanto maior a compatibilidade, maior será o peso de atenção atribuído àquele relacionamento.
É esse processo que determina quais informações serão usadas para construir a representação final de cada palavra.
Como a IA calcula a atenção?
Embora o conceito seja intuitivo, a implementação envolve bastante matemática.
Primeiro, cada palavra é convertida em um embedding, ou seja, um vetor numérico que representa seu significado.
Em seguida, esses embeddings são transformados em Queries, Keys e Values por meio de multiplicações por matrizes aprendidas durante o treinamento.
O próximo passo é calcular o quanto cada Query se relaciona com todas as Keys da frase. Isso é feito por meio do produto escalar (dot product), que mede a similaridade entre vetores.
Os resultados passam por uma função chamada Softmax, que transforma esses valores em probabilidades. Assim, todos os pesos de atenção somam 1, permitindo que o modelo distribua sua “atenção” de forma equilibrada entre as palavras.
Por fim, esses pesos são aplicados aos respectivos Values, gerando uma nova representação vetorial para cada palavra, agora enriquecida pelo contexto da frase.
Embora tudo isso aconteça em frações de segundo, são esses cálculos que permitem à IA interpretar corretamente o significado de um texto.
O que é Self-Attention?
O tipo mais famoso de Attention é chamado de Self-Attention.
Nesse mecanismo, cada palavra observa todas as outras palavras da mesma sequência.
Não existe uma palavra principal.
Todas podem influenciar todas.
Isso permite identificar relações mesmo quando dois termos estão separados por dezenas ou centenas de palavras.
Por exemplo:
“O pesquisador apresentou o algoritmo durante a conferência. Horas depois, ele recebeu um prêmio.”
Para entender quem recebeu o prêmio, a IA precisa associar o pronome “ele” ao termo “pesquisador”, mesmo existindo várias palavras entre eles.
Modelos antigos frequentemente erravam esse tipo de associação.
Já a Self-Attention consegue criar essa ligação diretamente, independentemente da distância entre os termos.
Multi-Head Attention: várias perspectivas ao mesmo tempo
Outra inovação importante é a Multi-Head Attention.
Em vez de utilizar apenas um mecanismo de atenção, o modelo cria diversos “cabeçalhos” independentes.
Cada um aprende a observar aspectos diferentes do texto.
Um pode focar em relações gramaticais.
Outro pode identificar o sujeito da frase.
Outro pode acompanhar verbos.
Outro pode prestar atenção em entidades como pessoas, lugares ou datas.
Depois, todas essas interpretações são combinadas.
É como reunir vários especialistas analisando o mesmo documento sob perspectivas diferentes antes de chegar a uma conclusão.
Essa abordagem aumenta significativamente a capacidade de compreensão do modelo.
Por que a Attention mudou a IA?
O impacto desse mecanismo foi enorme.
Graças à Attention, os modelos passaram a:
- compreender textos muito mais longos;
- interpretar contexto com maior precisão;
- resolver ambiguidades da linguagem;
- aprender relações complexas entre palavras;
- treinar de forma paralela em grandes conjuntos de dados;
- gerar respostas mais naturais e coerentes.
Ela também tornou viável o desenvolvimento de modelos com bilhões de parâmetros, algo que seria muito mais difícil utilizando arquiteturas recorrentes.
Sem esse avanço, provavelmente não existiriam os sistemas de IA generativa que utilizamos atualmente.
Onde a Attention aparece no dia a dia?
Embora seja invisível para a maioria das pessoas, a Attention está presente em praticamente todas as aplicações modernas de Inteligência Artificial.
Ela ajuda um chatbot a entender sua pergunta, permite que tradutores escolham a palavra mais adequada em outro idioma, melhora sistemas de busca semântica, auxilia na geração de legendas automáticas para imagens e contribui para resumir documentos longos mantendo apenas as informações mais relevantes.
Até modelos multimodais, capazes de interpretar texto, imagem, áudio e vídeo ao mesmo tempo, utilizam mecanismos de atenção para relacionar diferentes tipos de informação.
Sempre que uma IA parece compreender exatamente o contexto da sua pergunta, existe uma grande chance de a Attention estar trabalhando nos bastidores.
A tecnologia que ensinou a IA a prestar atenção
O mecanismo de Attention mudou a forma como máquinas processam linguagem.
Antes dele, computadores analisavam textos de maneira quase linear, frequentemente perdendo informações importantes ao longo do caminho.
Hoje, modelos conseguem observar todas as palavras ao mesmo tempo, identificar quais realmente importam e construir representações muito mais ricas do significado de cada frase.
Essa capacidade de estabelecer conexões contextuais é um dos principais motivos pelos quais a IA atual consegue conversar de forma tão natural, responder perguntas complexas e compreender nuances que, até poucos anos atrás, pareciam exclusivas da inteligência humana.
Em outras palavras, a Attention não apenas acelerou a evolução da Inteligência Artificial. Ela ensinou as máquinas a fazer algo que fazemos intuitivamente desde a infância: prestar atenção no que realmente importa.